
ChatGPTを生んだRLHFの共同発明者が、2年のステルスを経て公開したのは、文章を一文字も書かないAIでした。速さと安さが話題を集めていますが、TypeSafe AIが公開した評価データを開くと、効いているのはJevというモデルだけではないことが見えてきます。
TypeSafe AIは2026年9月15日、AIモデル「Jev」を早期アクセスで公開した。同社が「System Oneモデル」と呼ぶ新しい種類の第1弾で、文章を一切生成せず、あらかじめ定めた型に沿った判定と確率だけを返す。入力は100万トークンあたり0.042ドル、出力は無料、応答は70〜500ミリ秒。
創業者は元OpenAIのディオゴ・アルメイダ氏で、同社はシードで4000万ドルを調達している。同社が公開したワークフロー評価では、Jevの平均正解率は67.8%、1件あたり0.0004ドル、0.4秒だった。同じ評価では、すべてのモデルが判断を分解した場合にprompt方式より精度・費用・速度で上回っている。
対話を作った人が、対話から降りた
「モデルは何年も前からチャットで超人的なのに、自動化はどこにあるのか」
TypeSafe AIの創業者、ディオゴ・アルメイダ氏(Diogo Almeida)は、2026年9月15日の発表文をこの一文から始めています。同氏はOpenAIで、言語モデルに指示を守らせ人と話させるための手法を作った一人です。その研究はInstructGPTとRLHFとしてまとまり、ChatGPTの土台になりました。
その人物が2年間ステルスで作っていたのは、文章を一文字も書かないAIでした。
モデルの名は「Jev」。同社が「System Oneモデル」と呼ぶ新しい種類の第1弾で、9月15日に早期アクセスとして公開されました。同じ日、同社はDCVCをリード投資家とするシード4000万ドル(約62億円、1ドル=156円換算、2026年9月7日時点のレート)の調達も公表しています。共同創業者はエリック・ガフニ氏(Erik Gafni、CTO)とサーシャ・シェン氏(Sasha Sheng、COO)。2024年創業、サンフランシスコ拠点です。
名前の由来に、同社の賭けが表れています。System Oneはダニエル・カーネマンの『ファスト&スロー』の「システム1」、つまり速く直感的な判断から。Jevは経済学者ウィリアム・スタンレー・ジェヴォンズから取られました。石炭を燃やす効率が上がったとき、石炭の消費は減らずに爆発的に増えた──ジェヴォンズのパラドックスを、モデル名に据えているわけです。知能が一桁安くなれば、使い道は一桁増える。そう読んでいる、という宣言に近いものがあります。
発表の5日前、アルメイダ氏は自社ブログに「The Bitterest Lesson」という論考を置いています。機械学習で最も効くのは「正しいタスクを選ぶこと」であり、それはデータより、計算資源より、アルゴリズムより先に来る、という主張です。Jevはその主張の実装にあたります。
Jevは何を受け取り、何を返すのか
一般的な生成AIは、入力を受けて文章を一語ずつ順番に作ります。その文章がJSONであれ英文であれ、仕組みは同じです。受け取ったソフトウェアは、それを解析して型を検証し、はじめて処理に使えます。
Jevはこの流れを組み替えます。渡すのは2つ。判断材料となる「state」(テキストまたはJSON)と、答えの形をあらかじめ決めた「質問」です。返ってくるのは、型に沿った値と確率です。ChoiceとScoreには、確率分布を集約した確信度も付きます。文章は返りません。
質問は3種類しかない
| 型 | 問いの形 | 返るもの |
|---|---|---|
| Noul | この記述は正しいか | 0〜1の確率 |
| Choice | 選択肢から1つ選ぶと | 選ばれた値、各選択肢の確率、確信度 |
| Score | 段階評価で何点か | スコア、各段階の確率、確信度 |
Noulという耳慣れない語は、確率分布のベルヌーイ(Bernoulli)に由来する同社の造語です。アルメイダ氏はHacker Newsで、3つの型がプログラムの何に対応するかをこう説明しています。Choiceはmatch文に、Scoreは並べ替えに、Noulはif文に対応する、と。
3種類は1回の呼び出しに混ぜられます。しかもすべての質問が、同じstateに対して並列かつ独立に評価される。質問を増やしても応答時間はほとんど変わらず、質問同士が文脈を汚し合うこともありません。公式のクックブックには、13の質問を1リクエストにまとめても答えは変わらず、費用と速度が大きく改善したという例が載っています。改善幅の表記は公式サイト内で分かれており、11.5倍安く9.6倍速いとする記述と、12.2倍安く10.0倍速いとする記述があります。長い文書を1回だけ送れば済むためです。
確信度が、そのまま分岐になる
ChoiceとScoreの答えには、確率分布の形を0〜1に集約した「確信度」が付きます。分布が1点に集中していれば高く、平らに散っていれば低い。
公式ドキュメントが薦めるのは、これを3つに分けて使う設計です。高ければ自動で実行する。中くらいなら確認を挟む。低ければ人に回す。そして閾値は一律ではなく、行為の取り返しのつかなさに応じて変える。残高照会は緩く、送金承認は厳しく、という具合です。
同社は「知的なシステムが、人であれ機械であれ、正直な不確かさを表明できないなら、そのシステムは信頼できない」と書いています。速さや安さよりも、ここが設計の中心にあります。
価格は入力100万トークンあたり0.042ドル、出力は無料。現行モデルはjev-1.13.0。公式のモデル一覧では1リクエストあたり64kトークン、うちstateと最も長い質問の合計は32kトークンとされています(ドキュメントの別ページや外部の提供経路では32kとのみ示されており、表記が一致していません)。応答時間は70〜500ミリ秒です。
公式の数字を開くと、順位が入れ替わる
発表とともに広まったのは「193.6倍速く、444.6倍安い」という数字でした。ただ、同社は評価の元データを丸ごと公開しています。開いてみると、見出しとは少し違う像が出てきます。
Jevは「いちばん賢い」とは言っていない
4つの業務ワークフロー(セキュリティ警報、エージェントの実行ログ監査、請求書処理、カスタマーサポート)の平均が、こうなっています。
| モデル | 正解率 | 1件あたり費用 | 1件あたり時間 |
|---|---|---|---|
| OpenAI GPT-5.6 Sol(ワークフロー方式) | 74.1% | 0.0836ドル | 23.3秒 |
| Anthropic Claude Opus 5(ワークフロー方式) | 73.1% | 0.1761ドル | 37.8秒 |
| Anthropic Claude Sonnet 5(ワークフロー方式) | 67.8% | 0.1174ドル | 78.1秒 |
| TypeSafe Jev | 67.8% | 0.0004ドル | 0.4秒 |
JevはClaude Sonnet 5と同率で、GPT-5.6 SolとClaude Opus 5には届いていません。つまり同社の主張は「最も賢い」ではなく、System One型のタスクで同程度の知能を、桁違いに安く速く提供するというものです。この区別を落とすと、導入の検討は別のものになります。
数字の出どころにも注記が要ります。ここでの「正解」は、GPT-6 AstraとClaude Fable 5.1を高い推論設定で走らせた回答の平均です。人間が付けた正解ではなく、賢いモデル2つとの一致率を測っている。同社自身が「OpenAIとAnthropicのモデル寄りに偏る」と書き添えており、ワークフロー自体も同社の社内チームが作ったものだと明かしています。
同社は発表の4日前、「Lies, Damned Lies, and Benchmarks」という記事で、標準ベンチマークの表は今後も出さないと宣言しました。新しい評価は日付入りのスナップショットとして公開し、公開後はその評価を更新・最適化の対象から外す。スコアを追いかけて磨き込むことをしない、という意味です。自己評価であることは隠された弱点ではなく、公言された方針として読むのが正確です。
得意と不得意が、数字に出ている
平均より面白いのは内訳のほうです。
請求書処理でJevは61.8%。同じ課題でGPT-5.6 Solは79.1%、Claude Opus 5は78.4%を出しています。一方、カスタマーサポートではJevが76.0%で、首位のGPT-5.6 Sol(78.3%)に肉薄しました。
理由を推し量りたくなるところですが、ここは慎重に読む必要があります。公式の説明を見ると、請求書処理のワークフローでは合計、日付、口座番号、ステータスをモデルに尋ねず、コードで計算すると明記されています。Jevの苦手分野とされる計算や日付の比較は、そもそもこのワークフローではJevに回っていない。したがって61.8%という数字を、数値処理の弱さだけで説明することはできません。
読み取れるのは、業務によって得手不得手の差が大きいという事実のほうです。同じモデル、同じ設計思想でも、扱う判断の質が変われば十数ポイント動く。導入を検討するなら、平均値ではなく自分の業務に近いワークフローの数字を見るべきだということになります。
本当に効いていたのは、分解だったかもしれない
同じ評価表に、見出しにならなかった列があります。各モデルの「ワークフロー方式」と「prompt方式」の比較です。
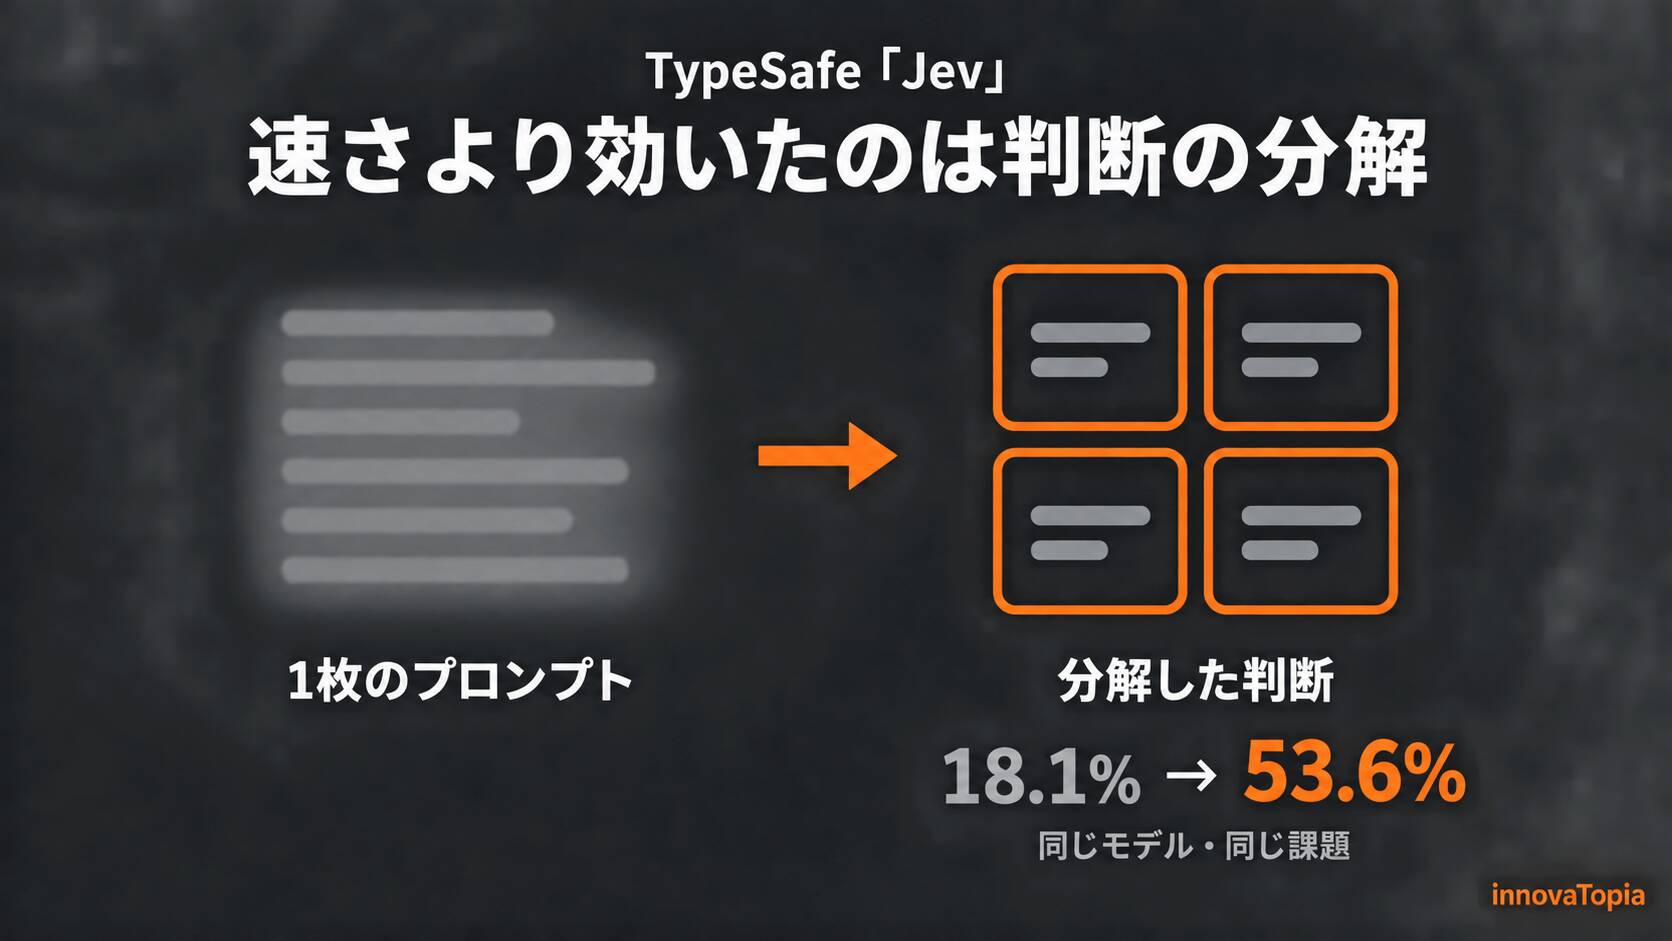
prompt方式は、課題をまるごと1つのプロンプトに投げてモデルに解かせるやり方。ワークフロー方式は、判断を小さく独立した質問に割り、答えをコード側で組み立てるやり方です。
結果は、全モデルがワークフロー方式で精度・費用・時間のすべてを改善しました。haiku 4.5は18.1%から53.6%へ。sonnet 5は60.4%から67.8%へ、費用は0.2251ドルから0.1174ドルへ。同社は評価サイトにこう書いています。「Structure is always better(構造化は常に優る)」。
ここが、この発表のいちばん実務的な含意だと考えます。
Jevが速く安いのは事実です。しかし今回公開された4つの業務ワークフローでは、判断を分解して型を決めるという設計が、評価対象となった全モデルで効いています。同社が自ら作った4業務の自己評価なので、あらゆるモデルとあらゆる業務で成り立つ一般則とまでは言えません。それでも、手元のパイプラインが「問い合わせ対応を自動化して」という一枚のプロンプトで動いているなら、モデルを差し替える前に、判断を割る余地が残っていないかを見る価値はあります。
公式ドキュメントの姿勢もこれと一貫しています。「System Oneはエージェントではない。コードを生成せず、自分の次の行動も選ばない」と明記され、制御フロー、決定的なルール、副作用はコード側に置き、AIは意味の判断だけを担うという設計が繰り返し説かれます。広い判断は、そのまま渡さず分解する。スタートアップの提案を評価したいなら「この提案を採点して」ではなく、市場規模、技術的実現性、差別化を別々に聞き、重み付けは自分のコードで書く。優先順位が変わったら、プロンプトを書き直すのではなく係数を1つ変える。
AIに全部を任せる設計から、AIに判断だけを任せる設計へ。Jevはその移行を前提にした道具であって、移行そのものを代わりにやってくれるものではありません。
「ハルシネーションしない」が指している範囲
発表文には「Jevはハルシネーションできない」という一文があり、これが最も議論を呼びました。Hacker Newsの投稿は1900点を超え、コメントは約500件に達しています(2026年9月20日時点)。最上位の批判はこうでした。無効な型は出せないが、完全に間違った有効値は出せるはずだ、と。
正確に切り分けると、こうなります。
保証されているのは、出力の形です。選択肢を3つ渡せば、定義していない4つ目は返りません。壊れたJSONも、存在しないフィールドも出てこない。同社の社名の由来でもある「型安全」がここです。出力形式の崩れを回復するために書いてきたコードの多くは、不要になります。逆に、誤った有効値の検出、API障害への備え、再試行、権限の確認、業務ルールの検証は、これまでどおり残ります。
ただし、出力の形を縛ること自体は新しい技術ではありません。たとえばOpenAIのStructured Outputsは、渡されたJSONスキーマを文法に変換し、そこから外れるトークンをマスクする制約付きデコードを使っています。vLLMのようなローカルの推論基盤にも、同種の機能があります。この点はHacker Newsでも早い段階で指摘されました。
TypeSafeがJevの差分の一つとして掲げるのが、選ばれた値に付く確率を、回答群の実際の正解率に対応させるよう、較正を学習目標に置いた点です。同社はこの手法をRLCDと呼び、新しいアーキテクチャと並列サンプラーもあわせて差分に挙げています。ただし学習法の詳細も論文も未公開で、独立した較正の検証もまだありません。較正はまとまった回答群について測る性質であり、確率の較正という概念自体もJevに固有のものではありません。
保証されていないのは、答えの中身です。3つのうち間違ったものを、高い確信度で選ぶことはありえます。
同社自身がこの区別に自覚的で、発表文のハルシネーション率0%のグラフには「この数字は実測ではない。スキーマ適合は保証されるので、自信を持って0%をプロットに足した」と注記しています。アルメイダ氏もHacker Newsで、「確率的なモデルである以上、自信を持って間違うことはありうる」と直接認めました。同氏は同時に、「ランダムフォレストがLLMと同じ意味でハルシネーションする、とは言わないのでは」とも返しています。
ここは、どちらが正しいというより、言葉の指す範囲が技術の変化に追いついていない場面だと捉えるのが実際に近いと思います。ハルシネーションという語は文章生成の文脈で生まれました。文章を生成しないモデルにその語を当てるとき、何が保証され何が保証されないのかは、作る側と使う側が毎回すり合わせるしかありません。確信度が返る設計は、そのすり合わせを言葉ではなく数字でやるための仕掛けでもあります。
使う前に読むページを、TypeSafeは自分で用意した
9つの弱点
同社は公式ドキュメントに「Jev 1.13 jaggedness(粗さ)」というページを設け、現行モデルの失敗モードを9つ挙げています(最終レビューは2026年9月17日)。文字通りに読みすぎる、計算と数え上げ、日付の比較、間接的な参照、無関係な情報が多いstate、敵対的な入力、指示と基準の矛盾、構造的な不変性、そして生成。
内容は具体的です。「Jevは電卓ではない」「日付は順序のある量ではなく文字列として読む」「stateに判断と無関係な情報が増えるほど精度は落ちる」。敵対的な入力については、stateはデータとして扱われ既定では敵対的だと見なされないため、プロンプトインジェクションは答えを動かしうると明記されています。
最も率直なのは「構造的な不変性」の項でしょう。同じ「返金を求めていますか」という問いをNoulで聞くと0.22、Choiceで聞くと「はい」が0.01。ある問いとその否定をNoulで別々に聞くと、確率の和が1.19になる。自社モデルが数学的な整合を満たさない実例を、数字ごと載せているわけです。そのうえで「構造的な不変性を当てにするな」「Noulで調整した閾値をChoiceに持ち込むな」と使い方を指示しています。
発表と同じ週にこの粗さのページが出ていることは、導入を検討する側にとってはむしろ助けになります。何が宿題として残っているかが、探さなくても分かる状態にあるからです。
日本語で使うとき
日本の読者にとって最も重要な記述は、価格表と同じページにあります。
英語が主要な学習言語であり、現時点で精度が最も高い。CJK(中国語・日本語・韓国語)を含む他の言語も扱えるが、同等ではない。非英語のワークロードに頼る前に、自分のデータで検証し、ルーティングの際は確信度に細心の注意を払うこと──公式ドキュメントはこう書いています。
海外のデモ動画で出た速度や一致率の数字を、そのまま日本語の業務に当てはめられる根拠は、現時点ではありません。試すこと自体の障壁は低く、公式APIの順番待ちを待たずとも、Vercel AI Gateway、Cloudflare Workers AI、OpenRouterからJevを呼べます。OpenRouterは公式と同じ入力単価を表示しています。LangChainにも公式の統合が用意されました。ただ、最初にやるべきは速度の追試ではなく、自分の日本語データでの一致率の測定になります。
判断を、ソフトウェアの側に取り戻す
独立した検証はまだ数が少なく、規模も小さい段階です。観測プラットフォームのArize AIが9月18日にまとめた事例では、英国のイベント情報サイトが出品審査でJevとGemini Flash-Liteを比べ、96%対86%で、1件あたりの費用は58分の1だったと報告されています。別の開発者は、1万8514件のスパムメールに対してゼロショットのJevを走らせ、そのラベルで訓練された分類器と統計的に互角の結果を得ました。
同じ記事は、失われるものも記録しています。Jevは判断の理由を説明しません。LLMを審査役に使うとき、なぜ不合格なのかという文章は、そのまま改善の手がかりになりました。Jevが返すのは選択値やスコアと確率であり、そう判断した理由を述べる文章ではありません。何が起きたかは分かっても、どう直すかの方向は自分で探すことになります。
そして同社は、この情報の偏りを承知のうえで作っています。自社の評価サイトの図が示していたのは、Jevが単独で勝ったという話ではなく、どのモデルも判断を分解したほうが良くなるという事実でした。「Build Prod, Not God(神ではなく、本番環境を作る)」というマニフェストの標語は、そこと地続きです。すべてができるモデルを目指すのではなく、コードが点検して行動できる狭い判断を提供する。
この数年、私たちはAIの出力を「読む」ことに慣れてきました。要約を読み、提案を読み、生成されたコードを読んで採否を決める。人間が読むことを前提に、モデルは饒舌さを磨いてきたとも言えます。
Jevが問い直しているのは、その前提の届く範囲です。問い合わせが届いたとき、裏側のプログラムが必要としているのは「請求に関するご相談のようです」という文章ではなく、「請求担当に送る」という判断だった。文章はその間に挟まった、人間のための通過儀礼だったのかもしれません。
もっとも、その判断を設計するのは今のところ人間です。何を選択肢に置き、どこで止め、どこから先を人に返すか。Jevはその設計図を書いてはくれません。書けるようにしてくれただけです。今日あなたが何度も繰り返した小さな判断のうち、どれを型にできるか。そこから先が、面白いところだと思います。
【関連記事】
【解説】MIT「HardFlow」|AIに破れない条件を守らせる
生成AIの出力を構造で縛るという、Jevと同じ問題意識を扱った記事。制約をどこに課すかという設計判断を解説している。
【編集部後記】
TypeSafeのチームページには、アルメイダ氏の経歴として、RLHFとInstructGPTの共同発明という記述が並んでいます。その下に、League of Legendsで北米トップ30、Hearthstoneで世界2位という一行が添えられています。
システム1とは、盤面を見て一瞬で次の一手を選ぶときに働くもののことです。その速度で勝ってきた人が、いま同じ速度を機械の側へ移そうとしている。名前の由来をカーネマンに求めた人の並びとして、これは偶然には見えません。
【用語解説】
System Oneモデル
TypeSafeが提唱する新しいモデル分類。文章を生成せず、あらかじめ型を定めた質問に対して判定値と確率を返す。カーネマンの「システム1」(速く直感的な思考)に由来する同社の造語であり、業界の標準分類ではない。
Noul/Choice/Score
Jevが受け付ける3種類の質問の型。Noulは「はい」の確率を0〜1で返し、Choiceは選択肢から1つを選び、Scoreは段階評価を返す。Noulは確率分布のベルヌーイに由来する同社の造語である。
state
Jevに渡す判断材料。テキスト、JSONオブジェクト、テキストの配列のいずれかで渡す。1回のリクエストに含まれるすべての質問が、同じstateに対して並列かつ独立に評価される。
確信度(confidence)
確率分布の形を0〜1に集約した値。分布が1点に集中していれば高く、散っていれば低い。ChoiceとScoreに付き、Noulには付かない。個々の答えの正しさを保証するものではなく、まとまった回答群について測る性質である。
較正(キャリブレーション)
モデルが述べる確率と、実際の正解率が対応している状態。確率0.8と答えた判断のうち約8割が当たる、という対応を指す。Jevに固有の概念ではない。
RLCD(Reinforcement Learning for Calibrated Decisions)
TypeSafeがJevの学習に用いたと説明する手法。人間の好みを報酬にするRLHF、答え合わせができる問題を使うRLVRに対し、較正そのものを学習目標に置くとされる。同社の造語であり、詳細と論文は未公開。
制約付きデコード
出力がスキーマから外れないよう、生成の各段階で許されないトークンを選べなくする技術。OpenAIのStructured Outputsや、vLLMなどのローカル推論基盤で使われている。
jaggedness(粗さ)
TypeSafeが公式ドキュメントに設けた、現行モデルの失敗モードを列挙するページの名称。計算、日付の比較、敵対的入力など9項目を、実例と数字つきで公開している。
ワークフロー方式とprompt方式
TypeSafeの評価で比較された2つの設計。prompt方式は課題をまるごと1つのプロンプトに投げる。ワークフロー方式は判断を小さく独立した質問に割り、答えをコード側で組み立てる。
【参考リンク】
TypeSafe AI(外部)
System Oneモデルを開発する米国のAIラボ。Jevの概要、料金、早期アクセスの申し込み窓口がまとまっている。
Introducing System One Models & Jev(外部)
Jevの発表文。設計思想、デモ、評価の条件、そして自社で付した注記までを、創業者のアルメイダ氏本人が書いている。
TypeSafe AI Workflow evals(外部)
4業務の評価結果。全モデルについて、ワークフロー方式とprompt方式の精度・費用・時間が並べて公開されている。
TypeSafe AI Docs: Models(外部)
料金、レート制限、コンテキスト長、対応言語の一覧。日本語を含むCJKの扱いに関する注意書きもここに置かれている。
TypeSafe AI Docs: Jev 1.13 jaggedness(外部)
現行モデルの失敗モード9項目。計算、日付の比較、敵対的入力などを、具体的な実例と数字つきで自ら公開している。
TypeSafe AI Docs: Confidence(外部)
確信度と確率の違い、閾値を行為のリスクに応じて変える設計の考え方をまとめたページ。三段階に分ける例も載る。
TypeSafe AI Docs: How to build with TypeSafe(外部)
判断を分解して型を決める設計の手引き。コードとAIの境界をどこに引くかが、具体的な例とともに書かれている。
The Bitterest Lesson(外部)
正しいタスクを選ぶことが、データや計算資源やアルゴリズムより効く。創業者が発表の5日前に公開した論考である。
Lies, Damned Lies, and Benchmarks(外部)
標準ベンチマークの表を出さないという方針の表明。自己評価という形を選んだ理由が、事例とともに説明されている。
TypeSafe AI Emerges From Stealth With $40M in Funding With New Model for Composable AI(Business Wire)(外部)
シード4000万ドルの調達を伝える発表主体のリリース。創業の年、拠点、創業者3名の経歴もあわせて記載されている。
Hacker News: Introducing System One Models and Jev(外部)
ローンチ時の議論の記録。ハルシネーションという表現をめぐる批判と、それに対する創業者本人の応答が読める。
Vercel: Jev now available on AI Gateway(外部)
AI Gateway経由でJevを呼ぶ手順。TypeSafeの順番待ちを経ずに試せる経路のひとつとして案内されている。
Cloudflare Workers AI: typesafe/jev(外部)
Workers AIからJevを使うための公式ドキュメント。サポートのルーティングなど、実装例もあわせて載っている。
OpenRouter: Typesafe(外部)
OpenRouter経由でのJev提供ページ。公式APIと同じ入力単価が表示されている。ベータとして提供されている。
LangChain: TypeSafe integrations(外部)
LangChainからJevの判定をRunnableとして扱う公式統合。エージェントの制御に組み込む例も示されている。
【参考記事】
TypeSafe’s Jev: Can decision models replace LLM judges?(外部)
観測プラットフォームArize AIによる分析。96%対86%、1万8514件のスパム判定など、独立した検証の数値を集めている。
TypeSafe Jev Review: The AI Model That Doesn’t Generate Text(外部)
公式評価が4業務711件であることや、並列質問の倍率を数値で追った検証記事。比較すべき相手は何かを整理している。
Jev: TypeSafe’s System One Model That Never Hallucinates(外部)
0%の型エラー率、70〜500ミリ秒という数値を軸に、RLHFやRLVRとの関係からRLCDの位置づけを説明した解説。
TypeSafe AI’s Jev Is Not an LLM — And That May Be the Point(外部)
193.6倍と444.6倍という数値を紹介しつつ、参照解答が他社モデルとの一致率である点を注記した記事。