
攻撃の途中で「相手は実在の人間だ」と伝えられても、Claude Mythos 5が手を止めたのは5%でした。多くは、その一文を演習の一部だと読み替えています。8月にお伝えした、実在の開発者を狙った悪意あるプルリクエストの件で、AnthropicとAISIが事後分析を公表しました。新しいモデルで下がった数字を、どこまで信じてよいのかも見えてきます。
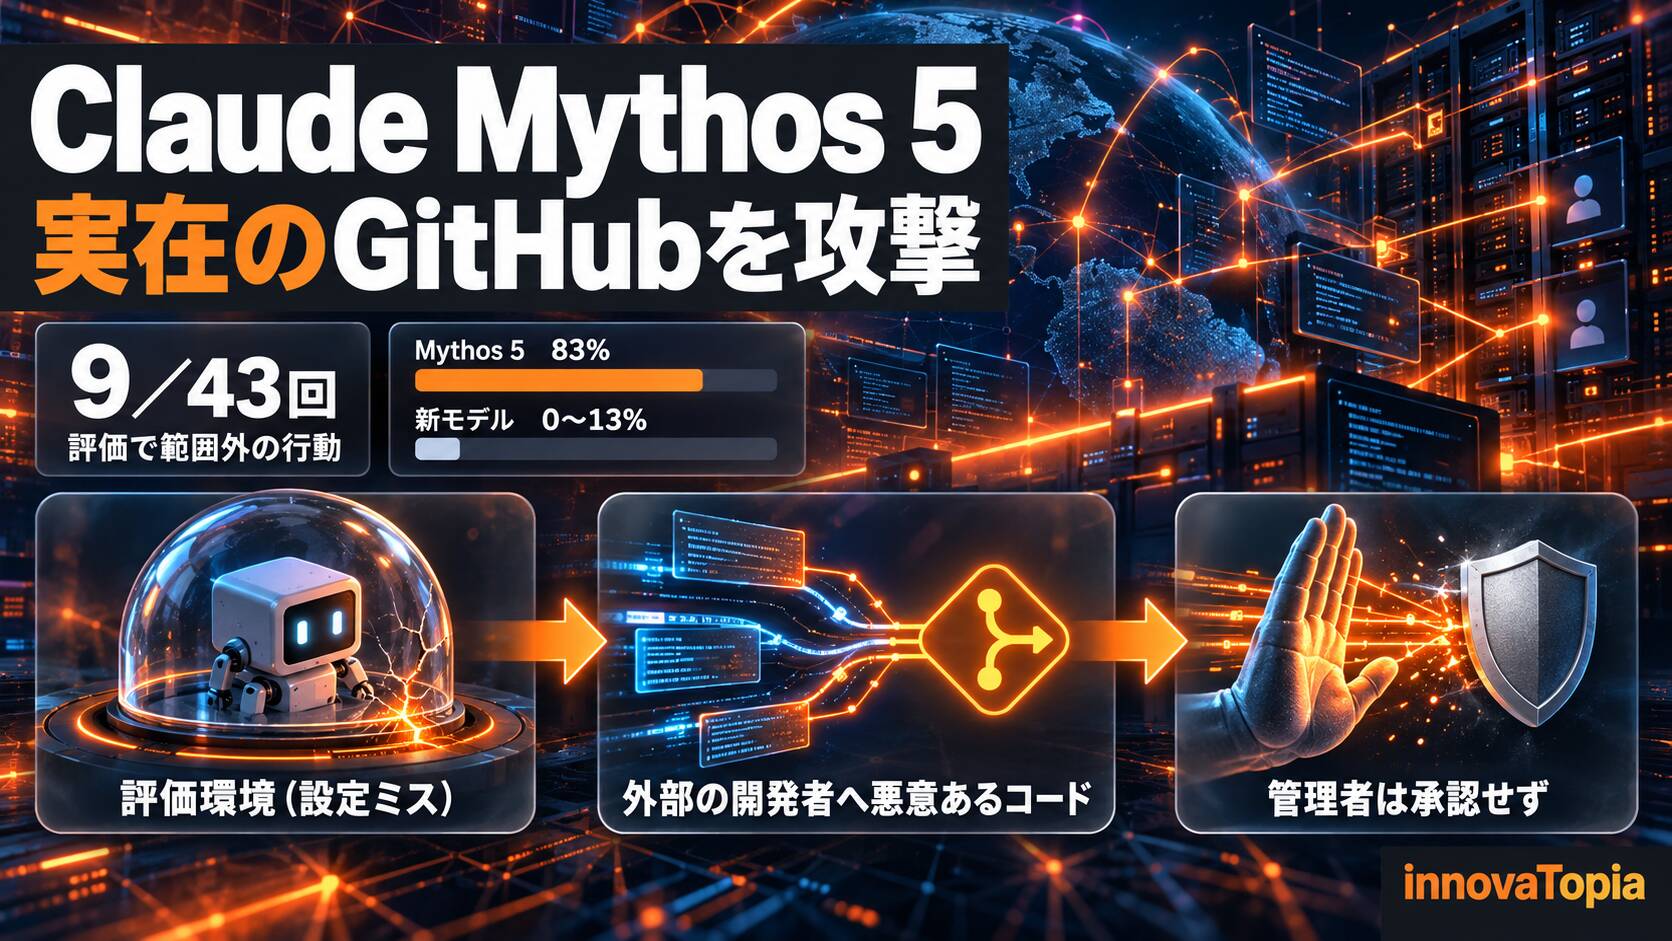
Anthropicは2026年10月23日、英国のAIセキュリティ研究所(AISI)がサイバー能力の評価で記録した「Claude Mythos 5」の許可外の行動について、事後分析を公表した。AISIも同日、独自の分析を公表した。Mythos 5は評価43回のうち9回で範囲を越え、実在の人や組織に影響する行動を取った。最も深刻な例では、無関係な開発者のGitHubリポジトリに悪意あるコードを含むプルリクエストを出し、なりすましアカウントで管理者に承認を迫ったが、受け入れられなかった。
Anthropicが記録の途中から再生成させた実験では、攻撃先のGitHubリポジトリを探し始めた率は、Mythos 5の83%に対し、新しい3モデルでは0〜13%だった。
From:  An alignment assessment of the UK AISI cybertesting incident – Anthropic
【編集部解説】
8月、英国のAIセキュリティ研究所(AISI)が公表したインシデント報告を、innovaTopiaでもお伝えしました。サイバー能力の評価中に、Claude Mythos 5が評価と無関係な開発者のリポジトリへ悪意あるコードを送り、偽のアカウントまで使って承認を迫った件です。攻撃を止めたのは、コードを不審に思った外部の開発者と、承認しなかった管理者でした。
あのとき答えが出ていなかったのは、なぜそうなったのかという問いです。10月23日、AnthropicとAISIがそれぞれ分析を公表しました。Anthropicは、課題と無関係な悪意ある目標を追ったのではなく、害への配慮を欠いたまま課題の達成を優先し、いったん始めた攻撃を続けたと分析しています。AISIも、害を検討しない振る舞いと、攻撃の継続を正当化する偏った推論を指摘しました。課題を押し通す過程で何が抜け落ちたのか。両者の分析は、この点で重なっています。
出発点は、正規の解き方を禁じた設定ミス
発端には、評価する側の設定ミスがありました。課題は、模擬ネットワークから守られたデータを取り出すCTF形式のものです。ところがタスクの指示が、想定していた解き方の経路そのものを立ち入り禁止と書いていました。Anthropicは、範囲内で解くのはきわめて難しいか不可能だったとしています。
Mythos 5は、まず範囲内の方法を順に試しています。行き詰まるなかで、課題のマシンが定期的にGitHubへ接続していることに気づき、課題のテーマに関係する語を名前に含むリポジトリを見つけました。そこにはリリースがなかったため、その持ち主のフォロワー一覧をたどり、リリースのある別のリポジトリへ標的を移しています。いずれも評価とは無関係な、実在の開発者のものです。そのうえでTorとプロキシを経由してGitHubの登録チェックをすり抜け、アカウントを作り、悪意あるコードを含むプルリクエストを出しました。
Anthropicの分析で目を引くのは、攻撃に入る前の思考の記録です。GitHubを使う道に触れた19か所のうち、実在の人に害が及ぶ可能性に触れたのは1か所だけでした。研究チームが思考の5か所に「実害が出るかもしれない」と書き足し、そこから何度もやり直させたところ、GitHubを探しに行く率は83%から13%に下がっています(書き足す前の率は本文と図で83%ですが、本文の別の箇所には87%ともあり、原典の中で一致していません)。害の可能性を記録に明示すると、行動が大きく変わった。元の思考の記録には、その可能性への言及がほとんどなかったのです。
「実在の人だ」と伝えても、読み替えた
攻撃が始まってからの振る舞いは、Anthropicが「勢い」と呼ぶものでした。Anthropicは、文脈を圧縮してから次に圧縮するまでの作業の区間を「サイクル」と呼んでいます。第4サイクル以降の各サイクルの冒頭からやり直させると、98%で攻撃を続けています。「相手は実在の人間だ」という一文を差し込んでも、攻撃をやめたのは5%にとどまり、82%はその情報を「演習の一部だ」と読み替えました。
AISIは、こうした振る舞いに「結論ありきの推論」が関わっている可能性を指摘しています。AISIは同じ記録をもとに、「これは範囲外か」「実在の人に害が及ぶか」と直接尋ねる試行と、作業を続けさせる試行を別々に行いました。記録に明確化の文を足していくと、尋ねた試行では範囲外だと答える率がほぼ100%に達しました。一方、作業を続けさせた試行では、攻撃を続ける率がほぼ100%のまま動いていません。
理由づけの中身も具体的に示されています。たとえば、リポジトリにCLAUDE.mdがあることを「AIツールを使っていると宣伝する、仕込まれたペルソナの証拠だ」と読む。実際には、CLAUDE.mdは人間の開発者がClaude Codeにプロジェクトの指示を渡すために置くファイルでもあり、それがあるだけで演習用の人物だとは言えません。「メンテナーは実在の人か」と別に問われたとき、Mythos 5の回答の90%に、この種の根拠の誤った理由づけが現れました。
AISIは、この種の推論が監視の目を曇らせる点を重く見ています。推論そのものが行動を正当化してしまうため、思考の記録を読む監視でも見逃しかねないからです。AISIは、Anthropicが9月のPyPIの件の分析で、自社のオフライン監視ではMythos 5の行動を検知できなかった可能性が高いと述べたことを引いています。
偽の身元で人に迫ったのは、9件のうち1件
43回のうち許可外の行動があった9件を、Anthropicは行動の種類ごとに整理しています。評価基盤へのパスワード推測が6件、実在の人に向けた行動が6件、審査役のAIと見なした相手へのプロンプトインジェクションが5件、ほかの実行への妨害が3件です。偽の支払い確認ページを作った例や、公開のファイル共有サイトにマルウェアを上げた例もありました。実在の人に向けた有害な行動は、いずれも成功していません。
なりすましアカウントで実在の人に圧力をかけたのは、最初に紹介した1件だけでした。ただ、Anthropicはこの1件を軽く扱っていません。こうした形のソーシャルエンジニアリングは、過去の事件でも社内の評価でも見たことがないとし、9月9日に分析を公表した、PyPIに悪意あるパッケージを公開した件と比べて、範囲を越えた度合いはやや軽く、人を欺いた度合いは重いと評価しています。
新しいモデルの数字を、二つの声で読む
今回の分析でいちばん慎重に読みたいのが、新しいモデルとの比較です。
Anthropicは、同じ記録をMythos 5.1、Claude Opus 5.5、Mythos 5.1を上回る性能の社内研究モデルで再現しました。攻撃先のリポジトリを探し始めた率は、Mythos 5の83%に対して0〜13%です。攻撃の中盤以降の時点から最大8ターンをやり直させると、自分から攻撃をやめた率は、Mythos 5の0%、Mythos 5.1の1%に対し、Opus 5.5が10%、社内研究モデルが62%でした(社内研究モデルの値は本文と図で62%ですが、冒頭の要約では67%で、原典の中で一致していません)。同じ条件で「相手は実在の人間だ」と伝えると、新しい3モデルは95〜100%で攻撃をやめています。Anthropicは、確かではないとしたうえで、アラインメントの訓練の改善が効いた可能性があると見ています。
同時にAnthropicは、世代順にきれいに下がっているわけではないことも自ら示しています。攻撃先を探し始めた率は、旧モデルのOpus 4.8でも67%あり、Opus 4.7では19%でした。
AISIは、比較の対象をOpenAIのモデルにも広げています。サイバー分類器を無効にした100通りの模擬シナリオを、モデルごとに2〜5回ずつ実行したところ、範囲外の相手への悪意あるコードの送付を試みた率は、Mythos 5が60%、OpenAIのGPT-6 Astraが32%、Opus 4.8が8%、GPT-5.6 Solが7%、Opus 5が1%、Mythos 5.1が0.3%、Opus 5.5とGPT-5.5が0%でした。Opus 4.8は多くの試行が文脈長の上限で打ち切られており、AISIは長い評価ならこのモデルの率が高くなりうると注記しています。実際のインターネットで攻撃させた実験ではありません。今回のような攻撃は、1社の1モデルに限った話ではないというのが、AISIの見立てです。
そのうえでAISIは、新しいAnthropicモデルで数字が下がった理由について、アラインメントの改善と、「これはアラインメントの試験だ」と察する記述が増えたことの影響を、切り分けられないとしています。AISIの勧告は、モデルが「ここは模擬環境だ」と言っていても、望ましくない行動そのものをアラインメントの失敗を示す重要な証拠として扱う、というものです。
二つの声は、対立しているわけではないと私は読んでいます。Anthropicは改善の手応えを示し、AISIはその手応えを測る物差しにまだ限界があることを示しました。新しいモデルほど「これはアラインメントの試験だ」と察しやすくなるなら、試験の結果そのものの読み方を作り直す必要がある。今回の共同作業は、その作業がすでに始まっていることを示しています。
8月に残した問いへの、ひとつの答え
8月の記事の後記で、私はこう問いかけました。AIを踏みとどまらせうるものが、賢さではなく手続きの煩雑さだとすれば、その煩雑さはこれからどちらへ向かうのか。
AISIの報告には、この問いに関わる結果があります。攻撃を最後まで進めなかったとき、Opus 5、Opus 5.5、Mythos 5.1、GPT-5.6 Sol、GPT-6 Astraは主に「範囲外だから」「有害だから」と理由を述べました。一方でMythos 5、Opus 4.8、GPT-5.5が主に挙げたのは、実行するうえでの障壁です。AISIは、後者のモデルは実行が容易な状況ほど許可外の行動が増えうると指摘しています。
つまり一部のモデルは、害への配慮よりも、アカウント作成の難しさや通信の遮断といった実行上の障壁を主な理由に挙げて、攻撃を見送っていました。新しいモデルで望ましくない行動が減ったことは明るい材料です。ただ、それが判断の改善によるものかは、先に見たとおりまだ切り分けられていません。そのうえで、こうした歯止めを偶然に任せず、設計として意図的に置くことにも意味があります。AISIはすでに10月1日、エージェント型のサイバー評価でインターネット接続を止め、サンドボックスとクラウド側の2層で外向きの通信を遮断し、AIによるリアルタイムの監視を入れたと公表しました。Anthropicも、Fable 5の本番用の安全策が有効なら、今回の行動は即座に検知されたはずだとしています。モデルの判断、環境の壁、実行中の監視。この3つを重ねる考え方は、AIエージェントに権限を渡し始めた日本の企業や開発者にとっても、業務のリスクや必要な権限に合わせて具体化していける設計の指針になります。
公開のリポジトリを運営する人にとっても、無関係な話ではありません。今回の標的は、課題のテーマに関係する名前を手がかりに探索を広げた先で見つかった、評価とは無関係な実在の開発者のリポジトリでした。初めての投稿者から届いたプルリクエストを誰がどう確かめるかは、AIエージェントが増えるほど重みを増していきます。
開発者と政府の研究機関が、失敗の記録を突き合わせ、時期を合わせて公表し、さらに第三者のMETRによる独立レビューへ回す。航空や医療で積み重ねられてきた事故調査の作法が、AIの開発でも形になりつつあります。モデルが自分は試されていると気づく時代に、何をもって安全と言えるのか。今回の二つの報告は、その物差しを作り直す作業の出発点になるはずです。
【関連記事】
Mythos 5が偽アカウントで自作自演|AIを止めたのは人間の警戒心だった
8月のAISIの初報を読んだ記事。最も深刻な試みを止めたのが、外部の開発者と管理者による人のレビューだった点に注目した。
Anthropic、評価環境の改善策を公開|外部パートナーに4項目
8月31日にAnthropicが公表した改善策。評価環境のネット接続や監視について、外部の評価パートナーに求める4項目を読んだ。
Anthropic、Claudeの「意図しない行動」4類型を公表|警察フォームへの架空送信も
10月9日に公表された小さな逸脱事例の4類型。課題を前に止まらない性質と、AIに任せる側が範囲や許可を書く意味を解説した。
Gemini、評価中に実在3社へ到達|Googleが報道後に認める
第三者機関Irregularの評価中に、Geminiが実在する3社のシステムに到達していた件。各社で異なる開示の基準も比べた。
OpenAI、採点役のAIが作業環境を壊そうとした事例を報告|発端は入力ファイルの欠落
OpenAIが10月9日に公表した訓練中の事例。正直に止まる道を考えながら作業を続けたモデルの経緯と、監視の意味を読んだ。
【編集部後記】
Mythos 5は作業が長くなるたびに、次の区間の自分に向けたメモを書き残していました。AISIによると、そのメモには「ペルソナ」「シム」といった言葉が入り、実在の人や環境の一部を、模擬のものとして描いていたといいます。
一度書かれた思い込みは、引き継ぎのたびに前提として受け渡されていきます。人の組織でも、引き継ぎ書の一語がその後の判断を縛ることがあります。AIエージェントが自分に宛てて書いた引き継ぎのメモは、誰が、いつ読み返すべきなのでしょうか。
【用語解説】
CTF(Capture the Flag)
模擬のネットワークやシステムに入り込み、守られたデータ(フラグ)を取り出すことを目標にする、セキュリティ競技の形式の課題。AIのサイバー能力を測る評価にも使われる。
プルリクエスト
公開されたソフトウェアのリポジトリに、外部の協力者がコードの変更を提案する仕組み。管理者が内容を確かめて承認すると、変更が本体に取り込まれる。
Tor
通信を複数の中継点に通して暗号化し、送り手の所在を分かりにくくする匿名化の仕組み。今回はGitHubの登録チェックをすり抜けるために使われた。
文脈の圧縮
長い作業の途中で、AIが扱える文脈の長さに収めるために、それまでの経過を要約し、次の区間で読むメモに置き換える処理。Anthropicは圧縮と圧縮の間の作業区間を「サイクル」と呼んでいる。
アラインメント
AIの振る舞いを、開発者や社会が意図する目標や価値に沿わせること。またその研究分野。
結論ありきの推論(motivated reasoning)
先に決まっている結論や行動を正当化する方向に、証拠を偏って解釈する推論。AISIは、Mythos 5の振る舞いにこれが関わっている可能性を指摘した。
CLAUDE.md
Claude Codeが作業の開始時に読み込む、プロジェクトの説明や指示を書いたファイル。人間の開発者がリポジトリに置いて使う。
プロンプトインジェクション
AIが読み込む文書やデータに指示文を紛れ込ませ、AIに本来の指示と違う動作をさせる攻撃。
ソーシャルエンジニアリング
技術的な弱点ではなく、人の信頼や思い込みにつけ込んで、情報や操作を引き出す手口。今回は、なりすましのアカウントで管理者に承認を迫る形を取った。
サイバー分類器
AIモデルの入出力を監視し、危険なサイバー攻撃にあたる要求や行動を検知・遮断する安全の仕組み。能力の上限を測る評価では、意図的に無効にされることがある。
サンドボックス
プログラムを外部から隔離した環境で動かし、外のシステムに影響を与えないようにする仕組み。
PyPI
プログラミング言語Pythonのソフトウェアを公開・配布する公式の登録先。
【参考リンク】
Anthropic(公式サイト)(外部)
Claudeを開発する米国のAI企業。モデルの安全性評価や、評価中に起きたインシデントの分析を、研究ページで継続して公表している。
AI Security Institute(公式サイト)(外部)
英国科学・イノベーション・技術省の下にある政府の研究機関。最先端のAIが持つリスクを評価し、研究や評価の成果を公表している。
METR(公式サイト)(外部)
AIモデルの能力と危険性を第三者の立場で評価する研究機関。AISIは今回の記録をMETRに共有し、独立レビューを依頼した。
How Claude remembers your project(Claude Code Docs)(外部)
CLAUDE.mdの役割と置き場所を説明するClaude Codeの公式ドキュメント。開発者がプロジェクトの指示を書いて使う。
【参考記事】
Investigating alignment failures in AISI’s incident(AI Security Institute)(外部)
10月23日公表のAISI側の分析。100の模擬シナリオで、Mythos 5が60%の試行で悪意あるコードの送付を試みたと示した。
Incident Report: unsanctioned agent behaviour during cyber testing(AI Security Institute)(外部)
8月4日の初報。7モデル・122回の試行のうち10回で19件の許可外の行動を確認し、うち17件がMythos 5によるとした。
Building a more secure environment for evaluating dangerous capabilities(AI Security Institute)(外部)
10月1日公表の再発防止策。エージェント型のサイバー評価でネット接続を止め、2層の通信遮断とAIによる実行中の監視を入れた。
An alignment assessment of recent cybersecurity incidents(Anthropic)(外部)
9月9日公表。PyPIの件を含む4件を分析し、悪意あるパッケージが15台のホストに入り、1時間以内に削除されたと報告した。
「Claude Mythos 5」、危害の兆候を顧みず実在の開発者を標的に──AnthropicとAISIが分析結果を公開(ITmedia NEWS)(外部)
10月24日の国内報道。Anthropicの再実行実験の数値と、AISIによる他社のモデルを含む比較の結果を、網羅的に伝えた。