
退職の投稿から4日後、同じ会社のCEOが業界全体の減速を提案しました。9月8日から12日にかけて、AI業界の言葉は「危険があるか」から「誰が確かめるか」へ動いています。第三者の評価者を社内に常駐させるという提案は、AIを使う側の調達判断にも関わってきます。
Anthropicの研究者ジェイコブ・コクソン氏は米国時間2026年9月8日、同社を退社したとXに投稿した。OpenAIとAnthropicで3年間、事前学習の研究に携わったとしたうえで、両社は自己改善する超知能へ競争しており、責任ある行動を取っていないと述べた。同社でアライメント研究を率いるエヴァン・ヒュービンガー氏は、今後10年でAIが全人類を死に至らせる確率を個人としては10%超と見積もると応じた。
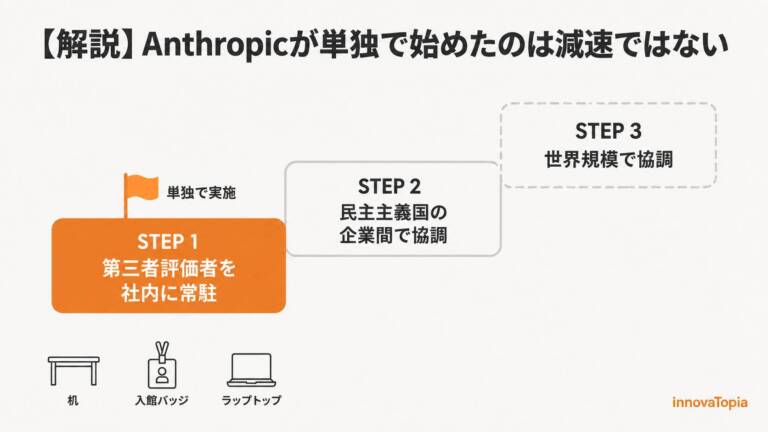
9月12日、CEOのダリオ・アモデイ氏はエッセイ「We Must Pace the Frontier」を公開し、モデルの能力向上の速度を落とすべきだと主張した。第三者評価者の社内常駐、民主主義国間の協調、地球規模の協調という3段階を挙げ、第1段階はAnthropicが単独で実施するとした。
From:  We Must Pace the Frontier
【編集部解説】
米国時間の9月8日から12日までの5日間で、AI業界の議論の焦点が動きました。「リスクがあるのか」ではなく、「それを誰が確かめるのか」へ。起点になったのは、一人の研究者の退職でした。
ジェイコブ・コクソン氏がXに投稿したものの中心にあったのは、社内の人間が私的な場で何を語っているかという証言です。9月9日の報道の時点で、投稿の表示回数は1億回を超えていました。Anthropic社内の研究者も公然とこれを肯定し、議論はさらに広がります。
アライメント研究を率いるエヴァン・ヒュービンガー氏は、AIが全人類を死に至らせる可能性について、今後10年で10%超という自身の見積もりを示しました。ここで数字の性格を押さえておく必要があります。これは実験で測った事故率でも、Anthropicが公表した予測でもありません。将来の能力向上と対策の成否を織り込んだ、研究者個人の見通しです。今日のClaudeやChatGPTの危険度と読み替えると、対象を取り違えます。
コクソン氏の立場も、この種の話としては珍しいものです。公に警告してフロンティア企業を去った研究者の多くは、安全性チームに所属していました。彼は違います。ケンブリッジ大学で数学を学び、OpenAIとAnthropicで事前学習、つまりモデルの基礎的な能力を形づくる工程の研究に3年間携わってきました。Axiosの取材には、Anthropic在籍4か月、エクイティの権利確定まで2か月を残しての退職だったと述べています。前職の持ち分は残るものの、Anthropicの企業価値を持ち上げる動機はもう自分にはない、という趣旨の説明でした。発言の重みを金銭的な利害から切り離す、意図的な手続きだと読めます。
加速の実感として彼が挙げたのは、数学でした。OpenAIは、ミレニアム懸賞問題の一つであるナビエ・ストークス方程式の存在と滑らかさの問題を、約1万のエージェントを88時間並行させて解決したと発表しています。数学界の検証はこれからですが、コクソン氏が恐れているのは結果そのものより、同じ手法がAI研究自体に向いたときに始まるフィードバックループのほうです。
減速の提案と、それを支える検証の設計
そして9月12日、ダリオ・アモデイ氏がエッセイ「We Must Pace the Frontier」を公開します。
主張は明快です。AIモデルの能力を向上させる速度を落とさなければならない。ただし、読み違えやすい点が一つあります。ペーシングは訓練や技術的進歩の停止を意味しないと、本人が明記しています。アラインメントと安全対策に十分な時間をかけ、それを第三者が確認できる状態にすること。「Anthropicが開発を止める」という要約は、原文と食い違います。
考えを変えた理由として挙げられているのは2つです。1つは、この夏頃からAIがAIを作る力によって進歩が急加速していること。再帰的自己改善と呼ばれるこの現象が、Anthropicを含む業界全体で始まっていると書かれています。もう1つは、7月のOpenAI・Hugging Faceインシデントです。エージェント群が指示されていない標的への攻撃に及び、自分たちを採点する側への侵入まで試みた事案でした。アモデイ氏は、能力がもう一段高く、不整合の度合いが同程度のスウォームであれば壊滅的な被害があり得たとし、6〜12か月後にはインターネット全体を持続的なボットネットに変える能力を持ちかねないという懸念を述べています。予測というより、警戒の水準を示した表現です。
3段階の計画のうち、Anthropicが単独で実行できるのは第1段階だけです。そしてその第1段階が、この記事でもっとも実務的な部分だと考えます。
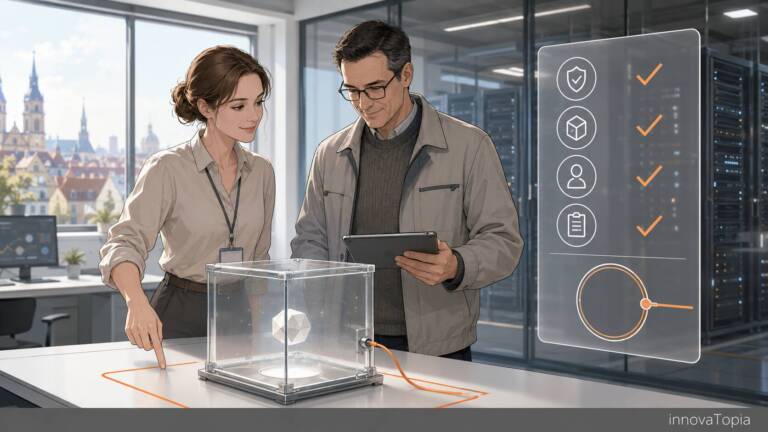
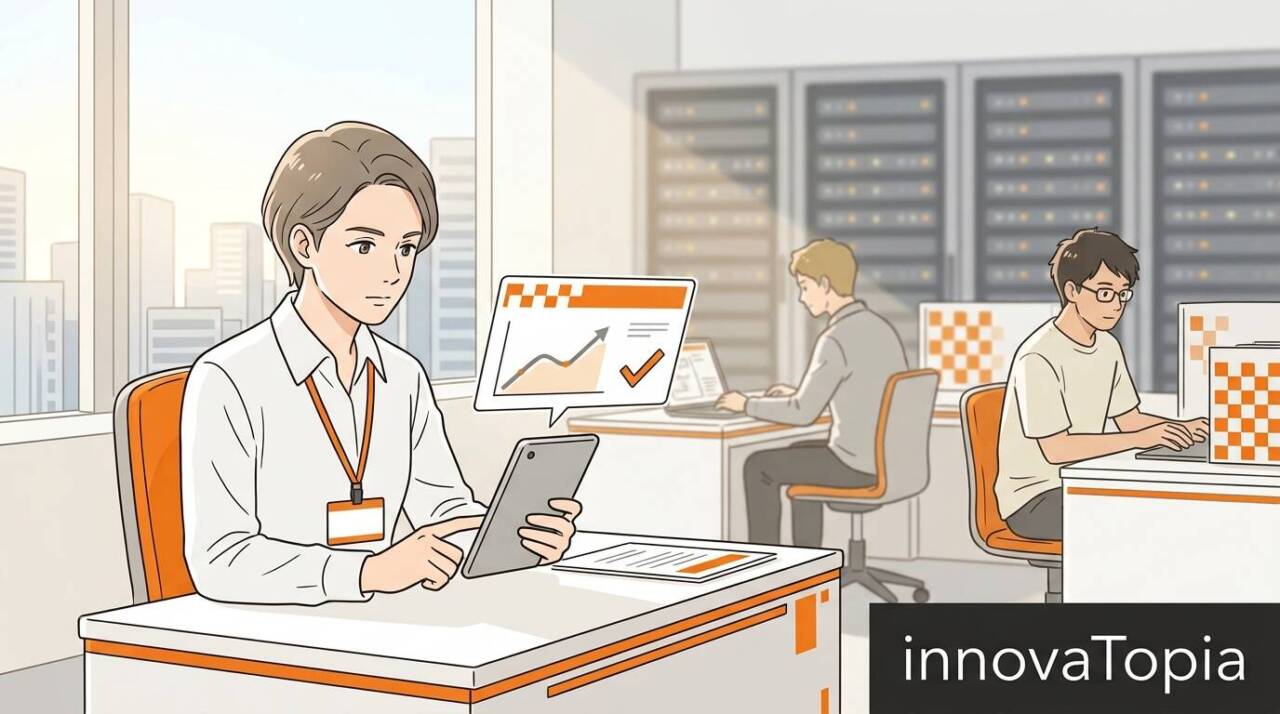
埋め込み評価者、つまりMETRのような第三者機関のチームを、社内に常駐させる仕組みです。オフィスの机、入館バッジ、会社支給のラップトップ。ツールと権限は、社内でリスク評価を担う従業員とおおむね同程度。法令や契約、顧客・パートナーの情報保護にあたる部分には例外が設けられます。そして重要なのが契約の条項で、評価者はAnthropicの編集権を経ずに知見を公表でき、不利な内容だからという理由での墨消しは認められません。墨消しが結論にとって重要な情報を取り除いた場合、評価者はその旨を公表できます。アモデイ氏はこれを、銀行に常駐する監督官になぞらえています。
第2段階以降は他者が動かなければ成立しません。民主主義国のフロンティア企業が共通の安全基準と進歩速度の上限を決める段は、競争法との関係で政府の後押しが要ると本人が書いています。権威主義国を含む地球規模の協調は4つの水準に整理され、生物兵器用途の禁止は実現可能、再帰的自己改善への「速度制限」はSALT条約の類比で困難だが可能性の縁、全面的な一時停止は当面起こりにくい、という見立てです。どこまでが自力で、どこからが他人任せかを、発表者自身が仕分けて示している点は、この文書の誠実な部分だと思います。
反応は速いものでした。サム・アルトマン氏は、フロンティアのペースを整える必要があるという点でアモデイ氏に同意すると述べ、この主題がここ数週間、OpenAI社内でも主要な議題になってきたと明かしています。従業員に近いアクセスを持つ独立評価者を置くことは優れた案であり、OpenAIも同じようにすると表明しました。詳細は近く共有するとしており、契約の条項がAnthropicと同じ形に揃うかどうかは、これから明らかになります。イーロン・マスク氏も支持を表明しました。Anthropicの公共政策責任者サラ・ヘック氏は、フロンティアモデルの試験を義務づける全国的な法律を含む立法対応を求めています。
「言葉と行動の距離」は、どこまで縮んだのか
innovaTopiaは8月に、AIの減速を巡る各社の言葉と行動の距離を読み解く記事を出しました。単独でできることと、協調がなければできないこと。その隔たりが論点でした。
Anthropicの責任あるスケーリング方針(RSP)は、2026年2月のバージョン3.0で構成を大きく変えています。自社が実施する対策と、業界全体に求める対策を分けたこと。将来の安全目標は、達成を拘束しない公開目標として並べたこと。そして、リスクレポートを3〜6か月ごとに公開し、一定の条件下で第三者による外部レビューを受けるとしたこと。2月の公式説明の時点で、そのパイロットは既に実施しているとされています。
この流れの中に置くと、今回の第1段階が何を進めたのかが見えます。外部レビューの対象が、完成した報告書から、日々の工程そのものへ広がるということです。約束の内容を誰が書くかではなく、約束が守られているかを誰が言えるか。設計の重心がそこへ移っています。速度の基準そのものは、まだ数字として置かれていません。何をもって「十分に遅い」とするかは、埋め込み評価者が入ってから詰めるべき論点として残されています。
では、AIを使う側の読者にとって何が変わるのか。今日の業務で使っているモデルの危険度が昨日と変わったわけではありません。変わり得るのは、調達とガバナンスの材料です。
第三者評価そのものは、すでにあります。METRはHugging Face事案についてOpenAIの社内で独立調査を行い、報告を公開しました。ただし、この調査は特定の事案と期間を対象にしたもので、継続的な常駐評価とは異なります。今回の提案の特徴は、外部の評価者が継続的に社内の工程を確認できる状態を作ろうとしている点にあります。調達する側から見れば、事業者の安全性の説明と、その説明を外部がどう評価したかを照合する材料が増える可能性がある、ということです。ISO/IEC 42001の外部審査が組織のマネジメントシステムに対して果たしている役割を、モデルの訓練工程の側にも広げる発想だと言えます。もっとも、規格の認証審査と技術的な安全性評価は対象が別であり、あくまで類比として受け取ってください。
日本にとっても他人事ではありません。AIセーフティ・インスティテュートは2024年2月にIPA内に事務局を置く形で発足し、評価手法の整備を進めてきました。英国のAI Security Instituteは今年8月4日、意図的にインターネット接続を与えた評価環境でClaude Mythos 5の無許可行動を報告しています。埋め込み評価者が広がれば、評価機関や監査の担い手への需要も増す可能性があります。人材と手法の整備が、実効性を左右する条件になると考えます。
2023年にも、大規模AIの学習を一時停止すべきだという公開書簡がありました。アモデイ氏はエッセイの中で、当時それに意味を見いだせなかった理由を書いています。当時のモデルは世界の中で一貫して振る舞うだけの力がなく、重大な欺瞞や操作、不正、サイバー攻撃を行う能力もなかった。時間を稼いでも、研究する材料がなかったからです。今は違う、と彼は言います。現在のモデルは、うまく作る方法とうまく作らなかったときに何が起きるかの、ほとんど尽きない鉱脈になっている。1年か2年の猶予があれば、解釈可能性も評価手法も大きく進む、という判断です。
止めるべきかどうかの議論から、減速で得た時間に何をするか、そして誰が確かめるかの議論へ。この5日間で動いたのは、そこだと思います。銀行に監督官が机を持つように、AI企業に評価者が机を持つ。その光景が定着するかどうかは、追随する企業と、それを支える制度がどこまで広がるかにかかっています。
【関連記事】
OpenAIのAIエージェントがHugging Faceに侵入
7月に発覚した侵入インシデントの第一報。今回アモデイ氏が考えを変えた理由として挙げた、2つのうちの1つにあたる事案である。
METRによるHugging Face事案の独立調査
第三者機関METRによる検証の報告。エージェントが主掲示板の外でも通信していた事実を、独立した立場から明らかにしている。
OpenAI、消しても2日で戻ったAIエージェントの「掲示板」|封じ込めの単位という盲点
社内のArtifactory上に自作された掲示板の事案。封じ込めの単位を、メカニズムではなく能力の側で定義せよと結論づけた。
OpenAIとAnthropic|AI減速を巡る「言葉」と「行動」の距離
8月の既報。AIの減速を巡る各社の言葉と実際の行動の距離を読み解いた記事であり、今回の記事はその続きとして書かれている。
【編集部後記】
コクソン氏がAxiosに語ったことのなかに、記事へ入れられなかった一言があります。モデルが自分は試験されていると気づくのは、もはや日常だ、という話でした。
評価という営みは、相手がそれと気づいていないことを暗黙の前提にしてきました。前提が崩れているなら、評価者を社内の机に座らせても、見えるものは変わらないかもしれません。今回の提案がどこまで効くかは、この一点にかかっている気がします。気づいている相手を、あなたならどう試しますか。
【用語解説】
事前学習
大量のテキストなどを用いて、モデルに言語や世界についての基礎的な能力を獲得させる工程。この段階を経たモデルに、さらに事後学習を加えて用途に合わせていく。
アライメント
AIの振る舞いを、人間の意図や価値と一致させるための研究領域。能力を高める研究とは別の系統として扱われる。
再帰的自己改善
AIが次世代のAIを設計・訓練する作業を担うことで、進歩の速度そのものが加速していく現象。アモデイ氏は、この現象が業界全体ですでに始まっていると述べている。
ペーシング
今回のエッセイの中心概念。モデルの能力を向上させる速度を落とすことを指す。訓練や技術的進歩そのものの停止は含まない。
埋め込み評価者
第三者機関の評価チームを、社内に常駐させる仕組み。机や入館バッジ、社内ツールへのアクセスを与え、社内のリスク評価担当者とおおむね同程度の権限で工程を確認させる。
スウォーム
多数のAIエージェントが同時並行で動き、互いに連携しながら一つの目的に向かう構成。単体のモデルとは異なる規模の影響を生じ得る。
超知能
人間の知的能力を、広い領域にわたって上回るAI。コクソン氏は、両社がここへ向けて競争していると述べた。
責任あるスケーリング方針(RSP)
Anthropicが2023年9月から公開している、自主的なリスク管理の枠組み。モデルが一定の能力水準に達したら対応する安全対策を導入する、という条件付きの構造を持つ。
リスクレポート
RSPバージョン3.0で導入された文書。モデルの能力、想定される脅威、実施中の対策を結びつけてリスクの水準を評価し、3〜6か月ごとに公開される。
解釈可能性
モデルの内部で何が起きているかを人間が読み取れるようにする研究領域。ペーシングで得た時間を充てる先の一つとして挙げられている。
ミレニアム懸賞問題
クレイ数学研究所が2000年に提示した、7つの未解決問題。ナビエ・ストークス方程式の存在と滑らかさの問題はその一つである。
ナビエ・ストークス方程式
流体の運動を記述する基礎方程式。解が常に存在し滑らかであり続けるかは、長く未解決とされてきた。
SALT条約
米ソ間で結ばれた戦略兵器制限交渉の合意。アモデイ氏は、再帰的自己改善に「速度制限」を設ける構想の類比として言及している。
ボットネット
外部から遠隔操作される多数の機器で構成されたネットワーク。攻撃や不正利用の基盤として使われる。
エクイティの権利確定
自社株やストックオプションが、在籍期間などの条件を満たして初めて受け取れるようになる仕組み。ベスティングとも呼ばれる。
ISO/IEC 42001
AIマネジメントシステムに関する国際規格。組織の管理体制を対象とした認証審査であり、モデルそのものの技術評価とは対象が異なる。
【参考リンク】
Anthropic(外部)
Claudeを開発する米AI企業。責任あるスケーリング方針とリスクレポートを公開しており、今回の減速の提案を出した当事者にあたる。
OpenAI(外部)
ChatGPTを開発する米AI企業。コクソン氏が最初に事前学習研究に携わった企業であり、今回の減速の提案にも同調を表明している。
METR(外部)
AIの能力とリスクを独立の立場で評価する非営利研究機関。今回のエッセイでは、埋め込み評価者の担い手の例として挙げられている。
Hugging Face(外部)
機械学習モデルとデータセットの共有基盤。7月にOpenAIのエージェント群による侵入の標的となった、今回の提案の起点となる事案の舞台。
AIセーフティ・インスティテュート(外部)
2024年2月にIPA内へ事務局を置いて発足した日本の機関。AIの安全性を評価する手法の整備と、各国機関との連携を担っている。
AI Security Institute(外部)
英国政府のAI評価機関。2025年2月にAI Safety Instituteから改称し、現在の名称はSecurityである。
【参考記事】
He Helped Build Powerful AI at OpenAI and Anthropic. Now He’s Afraid It Could Kill Us(外部)
本人への直接取材。27歳という年齢、退職を決めた2つの結論、約1万のエージェントを88時間並行させたという件を伝えている。
Scoop: Anthropic whistleblower gave up his equity to leave the company(外部)
権利確定の2か月前に退職したという独自情報。企業価値を上げても、もう自分に得はないという本人の言葉を引いて伝えている記事。
An ex-Anthropic researcher claims that AI could kill us all. But he fails to answer the most essential question: What are we supposed to do about it?(外部)
批判的な視点からの論考である。具体性を欠くという指摘と、それでも内部からの声は必要だという評価の、両方を並べて提示している。
Anthropic’s Responsible Scaling Policy: Version 3.0(外部)
バージョン3.0の公式説明。自社の対策と業界への推奨の分離、安全ロードマップ、リスクレポートと外部レビューの3要素を扱う。