
音声だけのAIにとって、ツールの処理を待つ数秒は沈黙の問題でした。顔が付くと、その数秒は画面の中で固まった表情として見えてしまいます。Googleが一般提供を始めたGemini 3.8 Liveのアバターは、この待ち時間の見え方にどう向き合ったのか。料金表と利用条件から読み解きます。
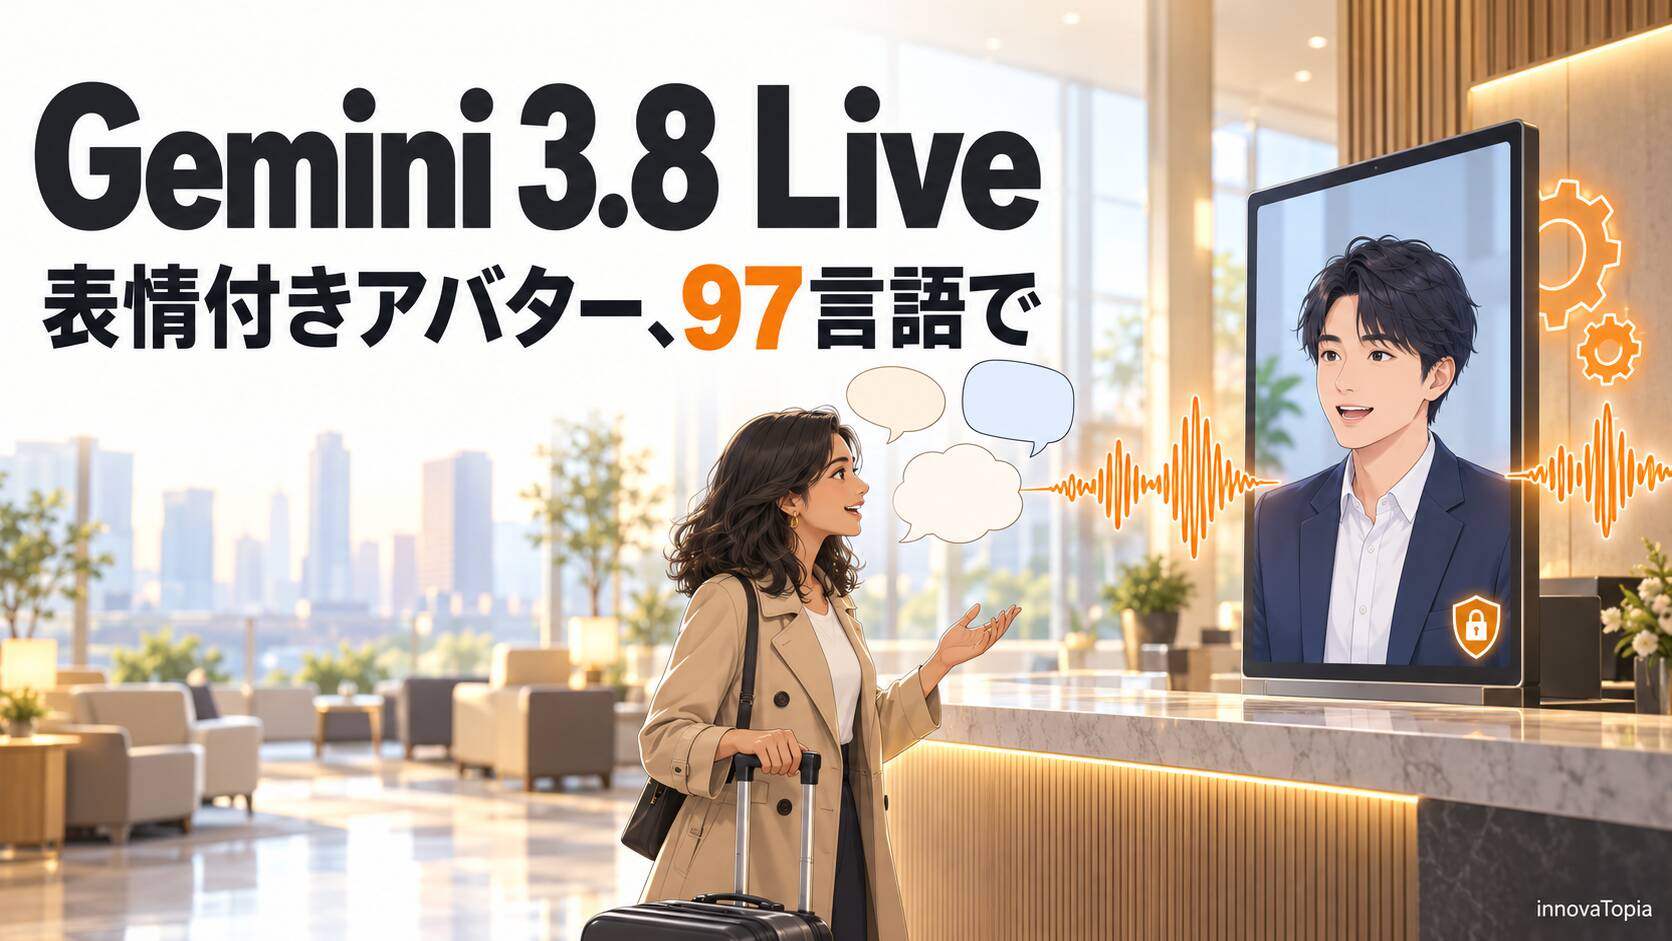
Googleは現地時間2026年9月24日、リアルタイムの音声対話モデルGemini 3.8 Liveに映像のアバターを組み合わせた「Gemini 3.8 Live with Live Avatar」を発表し、企業向けのGemini Enterpriseで提供を始めた。ほぼリアルタイムで生成する映像により、リップシンクと表情を伴う対話ができる。映像と音声の入力を同時に処理し、非同期のツール呼び出しによって、裏でデータを取得しながら会話を続ける。
97言語に対応し、会話の途中で言語を切り替えても口の動きと表情が追従する。既製アバターのライブラリを備え、参照画像からの独自アバター作成は企業向けの許可制とした。生成した音声と映像には、SynthIDの透かしを埋め込む。
From:  Introducing Gemini 3.8 Live with Live Avatar
【編集部解説】
「沈黙」の次は「静止」を埋める
先週のGemini 3.8 Liveの記事では、電話口の沈黙をどう埋めるかという課題を取り上げました。Extended Thinkingは短い受け答えと進み具合を伝える声で沈黙を埋め、3.8 Liveもツールを裏で実行している間、会話を止めません。音声だけのときに埋めるべきだったのは、無音の時間です。
顔が付くと、事情が変わります。画面の中の人物が固まれば、待ち時間はそのまま「止まった顔」として相手の目に入ります。Googleが今回、非同期のツール呼び出しを「途切れない存在感」という言葉と並べて打ち出したのは、この問題への答えだと私は読んでいます。
デモの題材がホテルのチェックインなのも象徴的です。Googleの説明では、裏でツールを呼び出しながら、対話を途切れさせずに続けます。人間の受付係が端末を操作しながら言葉をつなぐのと同じふるまいを、モデルの側で引き受ける設計です。
顔の値段と「数分」という設計
料金表を見ると、顔の重さが数字で分かります。映像の出力は100万トークンあたり1.00ドルで、アバターの映像は1秒6,192トークンと数えます。音声の出力は同12.00ドル、1秒25トークンです。
この単価から、アバターが60秒間話し続ける場合の出力分を計算すると、映像が約0.37ドル、音声が約0.02ドルです(私の試算。入力、テキスト出力、毎ターン課金される過去の文脈は含みません)。映像と音声の合計は、音声のみの約22倍になります。一方で、アバターが聞いている間は映像出力の料金がかかりません。
モデルカードは、アバター付きの対話が支えるのは数時間ではなく、数分の連続した対話だと明記しています。この制約と費用の設計を合わせて読むと、私は、受付や案内のように短い時間で完結する接客から使い道が広がっていくと考えます。Googleが例に挙げるのも、ホテルのチェックインのデモ、キオスク端末、Autotraderの車探しのアシスタントです。
顔の複製にも、本人性を守る門
今回の発表でもう一つ目を引くのは、本人そっくりの顔を作る機能に、はっきりとした門が設けられている点です。
提供の対象となる利用者は、用意された既製のアバターから選べます。私がGoogle Cloudのコンソールを開くと、アバターは11人、声は30種類並び、顔と声は別々に選べました。ドキュメントでも、既製のアバターと既製の声は自由に組み合わせられるとしています。
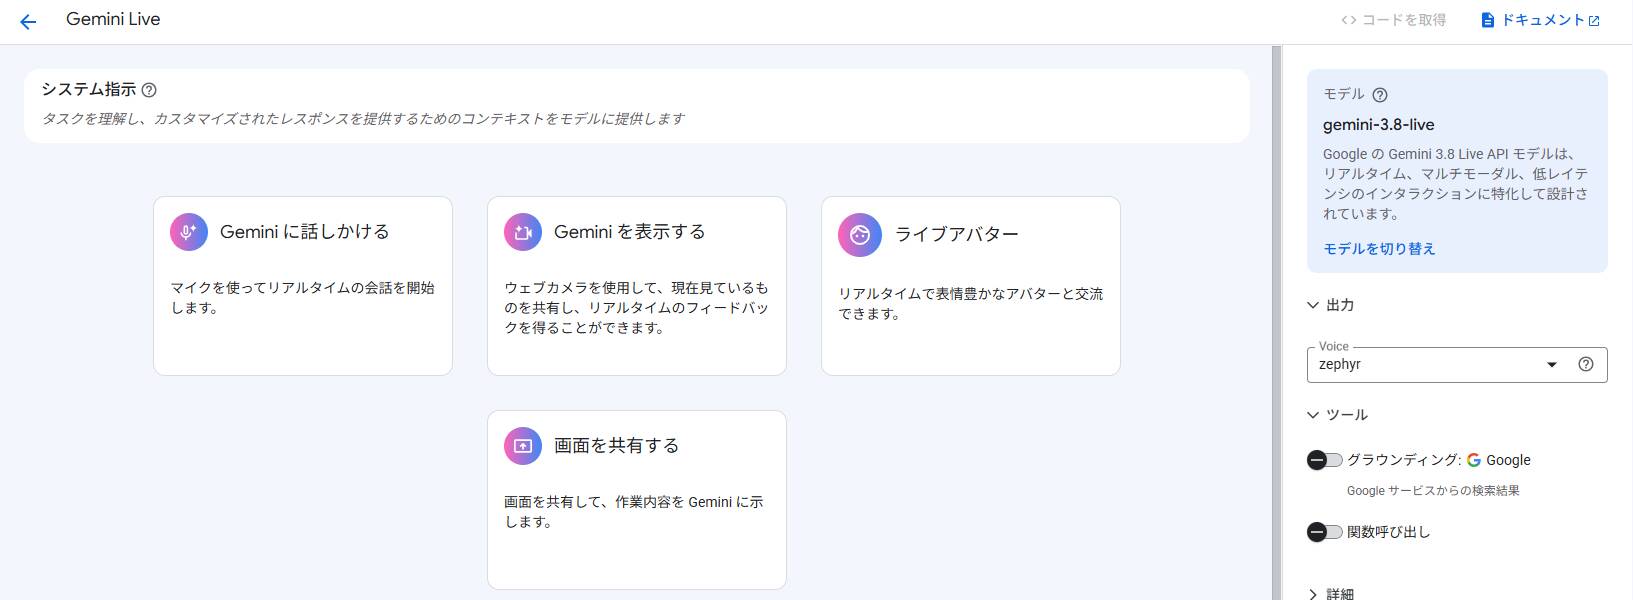
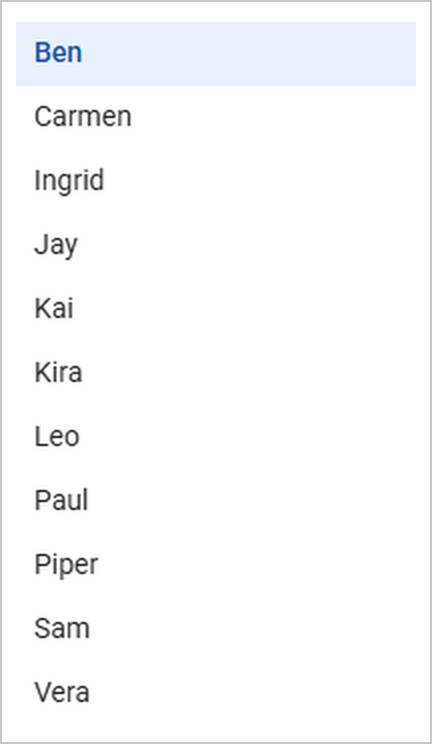
一方、参照画像から独自のアバターを作る機能は、企業向けの許可制と確認手続きを通った顧客に限られます。ドキュメントには画像をアップロードする手順も載っていますが、私の画面にアップロードの選択肢はありませんでした。顔と声のサンプルについて必要な同意と権利を確保するのは利用者の責任で、未成年や有名人の画像は使えません。
9月23日に発表されたGemini 3.8 Flash TTSは、声の複製に本人の同意録音を求めました。手続きは異なりますが、本人性を守るという点で、今回の許可制と通じています。Google Cloudのブログのデモでは、写真1枚と音声のサンプルから独自アバターを作っています。顔と声を写せるところまで来た技術に、Googleは機能ごとの利用条件を設けています。生成した音声と映像には、SynthIDの見えない透かしも埋め込まれます。
97言語の窓口が、日本に届くまで
日本の読者にとって魅力が大きいのは、97言語への対応と、会話の途中で言語を切り替えても口の動きと表情が追従する点でしょう。訪日客が多い駅や宿泊施設の窓口は、まさに短い時間で終わる多言語の接客の現場です。
一般提供のエンドポイントは、現時点では米国とEUです。日本の窓口で使うには、接続時の遅延やデータの取り扱いを含め、現場での検証が必要になります。それでも、画面の中の案内役が相手の言語に合わせて話し、表情を変える体験は、もう技術の実験ではなく、企業が本番で使える製品になりました。
AIに「顔」を与えることは、便利さと同時に「相手が誰なのか」を伝える責任を生みます。許可制と透かしは、その責任に向き合うための仕組みです。窓口に立たせる側が、相手にAIであることをどう伝えるかまで設計したとき、画面越しの接客は次の段階へ進むはずです。
【関連記事】
Gemini 3.8 Live、GPT-Live-1と分かれた音声AIの設計
GPT-Live-1とGemini 3.8 Liveを比べ、電話口の沈黙をどう埋めるかという、音声AIの設計の違いを読み解いた記事。
Gemini 3.8 Flash TTS、声の複製に本人の同意録音
Gemini 3.8 Flash TTSの発表から、声を写す機能に本人の同意録音を求めた仕組みと、日本の制作現場にとっての意味を考えた記事。
Gemini 3.8 Flash TTSで、AIキャラの声を作ってみた
Gemini 3.8 Flash TTSで、innovaTopiaの解説役の声を作り直した体験記事。手続き、費用、声の安定性を記録した。
【編集部後記】
モデルカードを読み進めて、知識の期限の欄で手が止まりました。Gemini 3.8 Audioが学習したデータは、2025年1月までです。
画面のアバターは今この瞬間に表情を変え、相手の言葉に合わせて口を動かします。それでも、自分の力だけで語れる世界は、1年半以上前で止まっています。その差を埋めるのが、裏で動くツールの呼び出しです。顔が自然になるほど、窓口の答えの確かさは、アバターの後ろで何とつながっているかで決まっていくのだと思います。
【用語解説】
Gemini 3.8 Live
Googleが2026年9月15日に発表した、リアルタイムの音声対話モデル。音声を聞いて音声で返し、映像の入力も扱う。会話を続けながら、裏でツールやAPIを呼び出せる。
Extended Thinking(Gemini 3.8 Live Extended Thinking)
3.8 Liveと同時に発表された上位版。推論と発話を同時に進め、処理を待つ間は短い受け答えや進み具合を声で伝える。
Gemini Enterprise
Googleの企業向けAIサービス。社内のデータとつなぎ、AIエージェントを業務で使うための入口となる。
Gemini 3.8 Flash TTS
Googleが9月23日に発表した音声合成モデル。文章で声を設計する機能と、録音から声を写す機能を備え、声を写すには元の話者本人の同意録音が要る。
リップシンク
音声に合わせて、口の動きを同期させる技術。
非同期のツール呼び出し
外部のツールやAPIの結果を待たずに会話を続け、結果が返った時点で応答に反映する仕組み。Gemini 3.8 Liveでは既定の呼び出し方になっている。
トークン
AIモデルが入力と出力を数える単位。Live Avatarでは、アバターの映像1秒を6,192トークン、音声1秒を25トークンとして料金を計算する。
モデルカード
AIモデルの用途、性能、制約、安全対策をまとめた公開文書。
エンドポイント
APIへの要求を受け付ける接続先。提供される地域ごとに用意される。
Autotrader
米国の自動車売買サイト。Cox Automotiveが、Live Avatarを使った車探しのアシスタントを作った。
【参考リンク】
Configure live avatars(Google Cloud)(外部)
Live Avatarの公式ドキュメント。既製アバターと声の選び方、独自アバターの条件、利用者が確保すべき権利と同意を記載している。
Agent Platform Pricing(Google Cloud)(外部)
Gemini 3.8 Live APIを含む料金表。アバターの映像出力の単価と、映像や音声をトークンに換算する率を掲載している。
Gemini 3.8 Audio モデルカード(Google DeepMind)(外部)
Gemini 3.8 Liveを含む音声モデル群のモデルカード。アバター付きの出力の上限と、連続対話が数分程度という制約を記載している。
SynthID(Google DeepMind)(外部)
AIが生成した画像、音声、テキスト、映像に、知覚できない透かしを埋め込んで識別する、Google DeepMindの技術の紹介ページ。
Gemini Audio(Google DeepMind)(外部)
話す、作る、音声を操るためのGeminiの音声モデル群を紹介する、Google DeepMindの公式ページ。音声対話のLiveも含む。
【参考記事】
Power your agents: Gemini 3.8 Live with Live Avatar is now generally available(外部)
Google Cloudによる一般提供の告知。米国とEUでの提供、独自アバターの許可制、写真1枚と音声からアバターを作るデモを紹介。
The Gemini 3.8 family is getting a little bigger with two new additions(外部)
2026年9月15日の報道。Gemini 3.8 Liveの97言語の切り替えと裏でのツール実行、上位版の推論と発話の同時進行を伝えた。
Gemini 3.8 text-to-speech says hello(外部)
2026年9月23日のGoogleの発表。Gemini 3.8 Flash TTSを公開し、声の複製に本人の同意録音を求める仕組みを紹介。