
IBMなどが量子プロセッサー(QPU)を計算基盤に組み込み始め、量子機械学習も脚光を浴びるなか、量子コンピューターへの期待は「既存のコンピューターにはできないことをやってのける」量子優位性・量子超越性に集約されてきました。AIが時代を押し上げたように、次は量子だという空気です。ただし核心は「量子は古典に勝てるか」ではなく「新しい計算原理が何をもたらすか」にあります。IBM Researchは2026年9月15日、浅い量子回路とLLM(大規模言語モデル)の間に理論的な分離が存在することを証明した論文を公開しました。「量子がAIに勝った」と読めそうな話題ですが、著者自身は結果を慎重に限定しています。何が証明され、何が証明されていないのか——探ってみます。
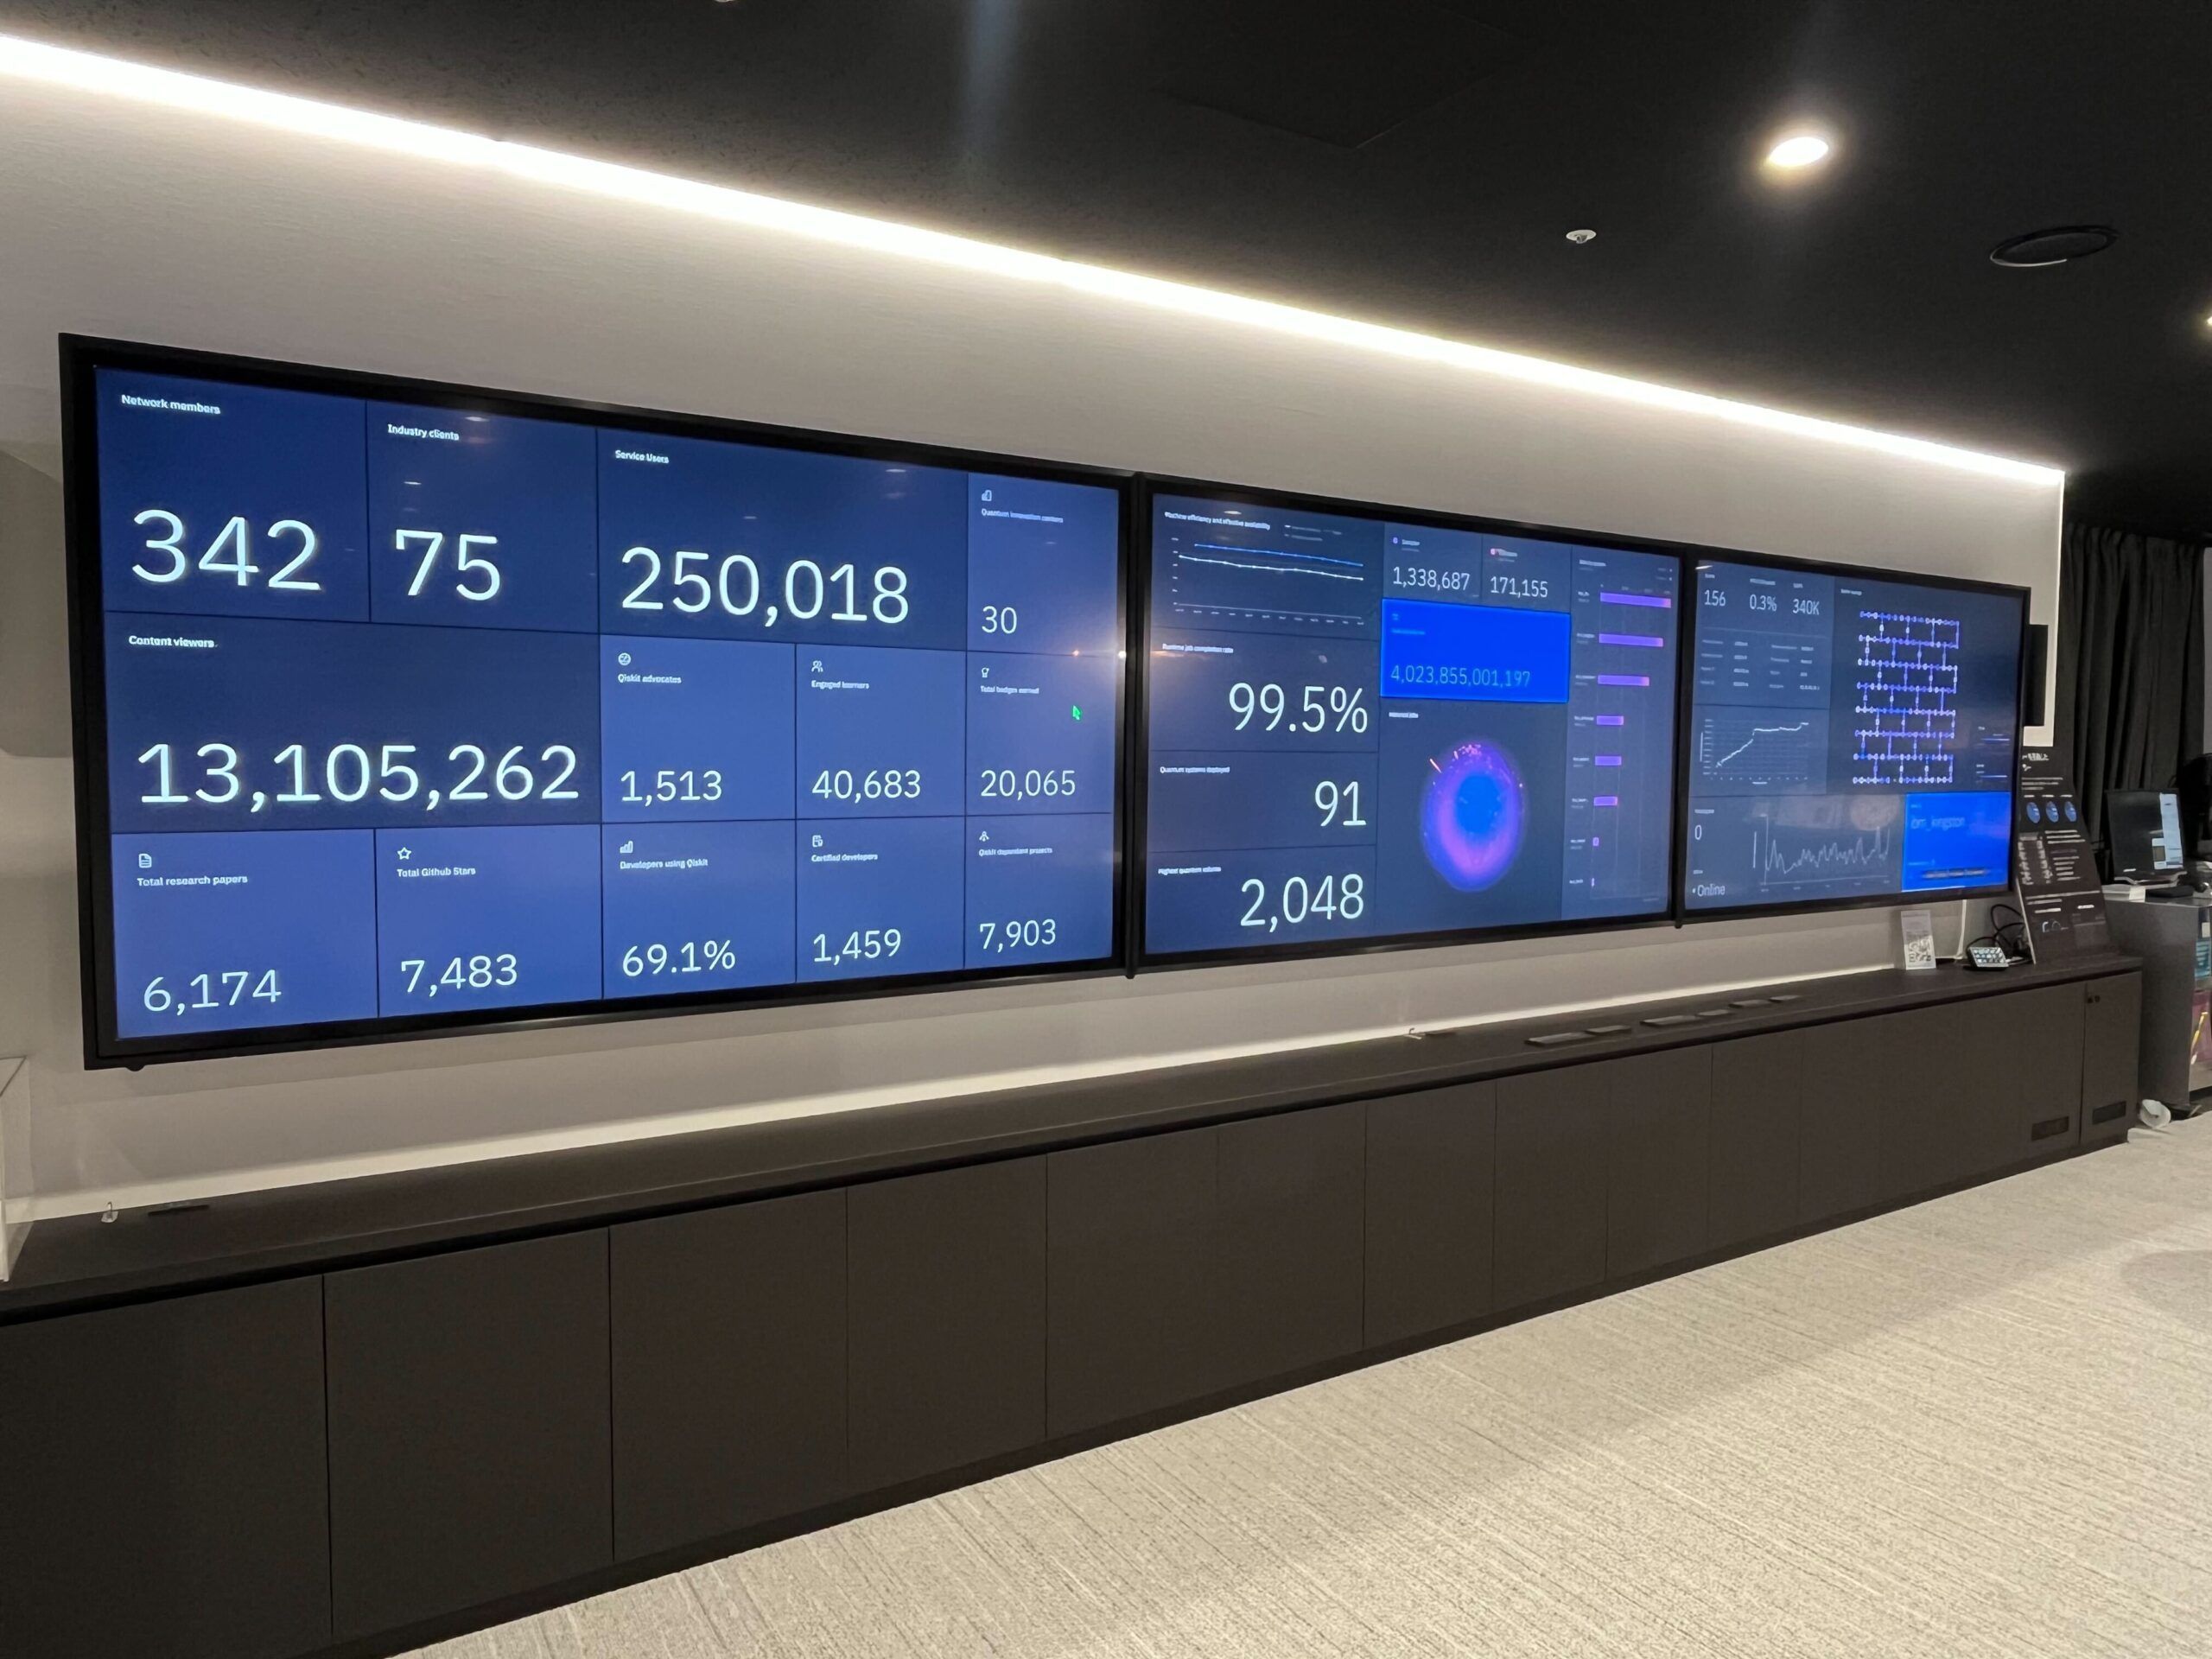
2026年9月15日に公開されたIBM Researchの論文は、浅い量子回路とLLM(大規模言語モデル)の間に理論的な分離が存在することを証明している。対象は、正しい出力を計算する「関数問題」と、確率分布に従って出力を生成する「サンプリング問題」の2種類である。前者では、GPTやClaude、Llamaが採用するdecoder-only型トランスフォーマーでは解くのが難しい「反復索引関数」を、浅い量子回路なら解けることを示した。後者では、chain-of-thoughtを備えた拡散言語モデルでも「パリティ・サンプリング」の分布を再現できないことを証明した。論文「Separating quantum circuits from classical LLMs」はArunachalam氏ら4名の共著で、2026年8月4日にarXivへ投稿された。
From:  Demonstrating a theoretical separation between quantum computers and large language models
【編集部解説】
「量子がAIに勝った」と読む前に
まず退けておきたい誤解があります。今回IBMが証明したのは、「量子コンピューターが実際にLLMより優れた性能を発揮した」という実証結果ではありません。60ページに及ぶ数学的証明によって、「ある特定の計算問題については、浅い量子回路が原理的にLLMより有利になる」ことを示した、理論計算機科学の成果です。
著者ら自身が、今日のLLMは成熟した大規模な計算ハードウェアの上で動く一方、今日の量子コンピューターはノイズだらけの小規模なものにすぎないと明記し、「どのスケールで量子が優位に転じるかは特定していない」と限定しています。証明された2つの分離――本の索引を何冊も辿っていく「反復索引関数」と、0と1の文字列の偶奇を当てる「パリティ・サンプリング」――は、いずれも複雑性理論の研究者が量子と古典の境界線を引くために設計した、いわば実験室的な問題です。ChatGPTやClaudeが日常業務で担っているタスクとは、かなり距離があります。
2018年から続く、地味で着実な8年間
この研究には、素性のいい系譜があります。起点は2018年、IBMのSergey Bravyi氏らがScience誌に発表した「定数深度の量子回路は、同等の古典回路には解けない探索問題を解ける」という証明です。この結果はセンセーショナルに報じられたわけではありませんが、その後の8年間、理論計算機科学のコミュニティの中で断続的に拡張が重ねられてきました。ノイズに強い形への拡張や平均ケースへの拡張が重ねられ、(当時)京都大学に在籍していたFrançois Le Gall氏(現・名古屋大学教授)による貢献も、この系譜の一部です。
つまり、今回のLLMとの分離証明も、「発表されたら終わり」の一発ネタではなく、今後数年かけて他の研究者が条件を強めたり対象を広げたりしていく連鎖の始まりだと見るのが妥当でしょう。裏を返せば、8年前の成果がいまだに製品や実用アプリケーションに直結していないという事実も、そのまま今回の結果に重ねて考えておく価値があります。「量子がAIに勝った」という見出しに飛びつく前に、この地味な時間軸を思い出しておきたいところです。
同じIBMが、逆方向の研究もしている
興味深いのは、IBM Research自身が今回とは逆方向の研究も並行して進めていることです。2026年6月に発表された別の研究では、Google DeepMindのAlphaEvolve/FunSearchの系譜を継ぐLLM主導の進化的探索フレームワークを使い、量子誤り訂正符号の候補を465種類発見したと報告しています。IBM Research自身、この研究を「量子コンピューティングと古典的AIの間で拡大しつつある双方向の相互作用の一例であり、それぞれが互いを進歩させ、加速させ始めている」と位置づけています。
量子側からAIを高度化する動きも並行して進んでいます。IonQは2025年、LLMのファインチューニング層に量子回路を組み込むハイブリッド構成を実証し、Multiverse Computingは2026年6月、IBMの156量子ビットプロセッサーを使い、LLM内部に小さな量子回路ブロックを挿入することでパラメータを大量に増やさずにメモリ制約を克服する手法を発表しています。
つまり同じ2026年、IBM内部だけを見ても、「量子はLLMより理論的に優れている」という論文と、「LLMが量子誤り訂正符号を発見する」という論文が相次いで出ているわけです。これは偶然というより、量子とAIが競合関係というより、互いを道具として使い合う関係に向かっていることの表れだと読むのが自然でしょう。
「競争」ではなく「コプロセッサ」
この見立ては、IBMだけのものではありません。査読誌に掲載されたある総説論文は、量子コンピューティングの位置づけを「古典的なAIと競合するのではなく、異なる種類の問題を解く手助けをするコプロセッサ」と表現しています。
ゴードン・ベル賞の最終候補にもなった量子×創薬研究(理化学研究所・クリーブランド・クリニック・IBMの共同研究)を行うクリーブランド・クリニックの最高リサーチ情報責任者、Lara Jehi氏も、同様の表現を使っています。「一方対他方のレースではない。二頭の馬を馬車に繋いで、一緒にどこまで遠くへ行けるかという話だ」。
業界の空気も、実は同じ方向を向いている
量子業界に対する市場の期待そのものも、「量子がAIに取って代わる」方向には振れていません。予測市場Manifold Marketsの集計では、2026年中に量子コンピューターが古典コンピューターを明確に上回る計算を実現する確率について、市場参加者の見立ては圧倒的に懐疑的だったと報じられています。
こうした慎重さの背景には、過去の苦い経験もあります。2019年にGoogleが発表した「量子超越性」の実証は、その後、古典コンピューターでも再現可能であることが示されました。「量子が古典に勝った」という主張は、これまでも繰り返し検証にさらされ、後から縮小・訂正されてきた歴史があります。量子研究者自身のブログでも、「基礎的な機械学習タスクでの優位性は証明されたが、それがLLMのような生成AIへの即時的な有用性を意味するわけではない」と、今回の論文と同じトーンの自制が語られています。
日本語圏でも、この「対立ではなく共存」という捉え方はすでに語られ始めています。日経クロステックは「量子コンピューターとAIは、排他的な関係にあるわけではなく、それぞれの特徴を生かして共存していく」「量子コンピューターの大きな応用の1つが、AIの主流技術である機械学習の高速化にある」と評しており、日経テックフォーサイトは2026年の展望キーワードとして「溶ける」を掲げ、「量子×AI」を技術境界が融合する筆頭例に位置づけています。
まだ、誰も大きく騒いでいない
もう一つ、記録しておきたい事実があります。この論文自体は2026年8月4日にarXivへ投稿されていましたが、IBMが自社ブログで解説記事として打ち出すまでの約1カ月半、量子コミュニティの反応はほぼ見当たりませんでした。ブログ公開後も、量子コンピューティング専門のニュースレターが淡々と一覧に掲載した程度で、著名な量子研究者による論評は、私たちが確認できた範囲では見当たりませんでした。AIによる自動査読サービスPithは、この論文について「トランスフォーマー側の下界証明に技術的なギャップがあり、拡散言語モデルの結果はタイトルが示唆するより限定的」という指摘を8月中旬に残していますが、これも人間の査読者による評価ではなく、参考情報にとどまります。
理論計算機科学は、もともと一般メディアが扱いにくい専門性の高い分野です。だからこそ、この静けさそのものが、量子が古典的なAIを打ち負かしたという単純化が、まだ誰にも検証されていない状態にあることを物語っているとも言えるでしょう。
【関連記事】
【解説】GPT-5.6 Sol、MITの量子ビット較正を自律実行
OpenAIのモデルがMITで量子ビットの較正作業を自律的にこなした事例。理論で「量子がLLMに勝る」証明が出た同じ週に、現場では「AIが量子を支える」動きも報じられていた。
IBMとシカゴ大学が量子優位性を実証、70論理量子ビットで「計算結果を信頼できる」証明に到達
IBMが自ら定義した量子優位性の基準を、自ら満たしたと発表した事例。「発表する側が基準も引いている」構図への慎重な読み方は、今回の記事にも通じる。
Google、誤りから学ぶ量子コンピューターを実証
Google DeepMindの強化学習が、量子誤り訂正のデコーダーに実際に組み込まれた事例。AIが量子ハードウェアの内側で実働している、好対照の記事。
【編集部後記】
量子とAIをめぐる報道は、これからも「どちらが勝つか」という言葉で語られ続けるでしょう。ですが今回たどってみて分かったのは、研究の現場では競争より掛け算の方がずっと面白いということでした。派手な見出しに出会ったとき、その奥にどんな地味な系譜が積み重なっているのか。次に同じような発表を目にしたとき、私たちも一度立ち止まって確かめてみたいと思います。
【参考リンク】
【用語解説】
浅い量子回路(Shallow Quantum Circuit)
量子ビット数が増えても回路の深さ(ゲートの層の数)が一定に保たれる量子回路。ノイズの影響を受けやすい現在の量子コンピューターでも実装しやすいとされ、量子と古典の理論的な境界線を引く研究で頻繁に用いられる。
decoder-only型トランスフォーマー
入力プロンプトを受け、新しいトークンを逐次生成するアーキテクチャ。GPT・Claude・Llamaなど、現在の主要なLLMの多くが採用している基盤構造。
chain-of-thought(思考の連鎖)
LLMが最終的な回答を出す前に、中間的な思考過程をトークンとして生成・利用する手法。モデルの推論能力を大きく引き上げる要素として知られる。
拡散言語モデル(Diffusion Language Model, DLM)
テキストをノイズで段階的に「汚し」、それを逆再生するように除去していくことで文章を生成する言語モデル。DALL·EやStable Diffusionなど画像生成分野の拡散モデルの考え方をテキストに応用したもの。
量子優位性(Quantum Advantage)
量子コンピューターが特定の計算課題において、古典コンピューターより速く・安く・正確に解けることを指す概念。同様の文脈で「量子超越性(Quantum Supremacy)」という語も使われるが、こちらは実用的な意味を問わない、より狭い技術的達成を指すことが多い。