日本語のチラシとインフォグラフィックで、Canva Craft、ChatGPT、Geminiの3つは、160字まで1文字も間違えませんでした。ところが英語の長い指示でドット絵を頼むと、結果は大きく分かれます。4つの画像生成AIを、同じ指示文で比べました。
前回の予告どおり、4つの画像生成AIで比べました
前回の記事で、Canvaの画像生成モデル「Canva Craft」を日本語のチラシで試しました。その最後に、ChatGPTやGeminiとも並べて比べると予告しました。今回はその続きです。
比べたのは、Canva Craft、ChatGPT、Gemini、Adobe Fireflyの4つです。デザインツールの会社が作った2つのモデルと、対話型AIに組み込まれた2つの画像生成を並べる組み合わせです。
お題は3つ用意しました。日本語の短い文字を入れるチラシ、日本語160字を並べるインフォグラフィック、英語の長い指示で描くドット絵のRPGです。試したのは2026年10月24日で、画面や機能はこの時点のものです。
【比べた条件】
4つとも、筆者が契約している有料プランで試しました。モデル名は、各サービスの画面に表示されたとおりに書いています。
| サービス | プラン(画面の表示) | 使ったモデル(画面の表示) |
|---|---|---|
| ChatGPT | ChatGPT Pro 100 | 表示なし |
| Gemini | Google AI Pro(5 TB) | Nano Banana 2.1(チラシの生成時に確認) |
| Canva | Canvaプロ | Canva Craft-1 2K |
| Adobe Firefly | Creative Cloud Pro | Firefly Image 5 |
比べ方は、次のように決めました。
- 同じ日に、同じ指示文を1文字も変えずに使う
- 縦横比は3:4を指定する(RPGは指示文で4:5を指定)
- 最初に出た結果を使い、作り直しはしない
- 「どれが一番か」は決めず、観察した違いを書く
Geminiは、画像のメニューで使ったモデル名を確認できました。ChatGPTには、モデル名の表示がありませんでした。Canva Craftは1回の生成で4枚の案を出すため、4枚の全体を見たうえで、1枚目を代表として並べています。
ただし、CanvaではRPGの4:5を画面で選べないため3:4で実行し、Fireflyも参考画像を添付すると3:4の表示になりました。縦横比の条件は完全にはそろっていません。
各お題は1回ずつの試行で、各モデルの成功率を測る試験ではありません。無料プランでは、使えるモデルや回数が変わる可能性もあります。今回の結果は、あくまでこの条件での観察です。
お題1:チラシでは、3つが日本語を正確に描きました
1つ目のお題は、前回と同じカフェのチラシです。今回は、入れる文字を絞る一文も最初から加えました。
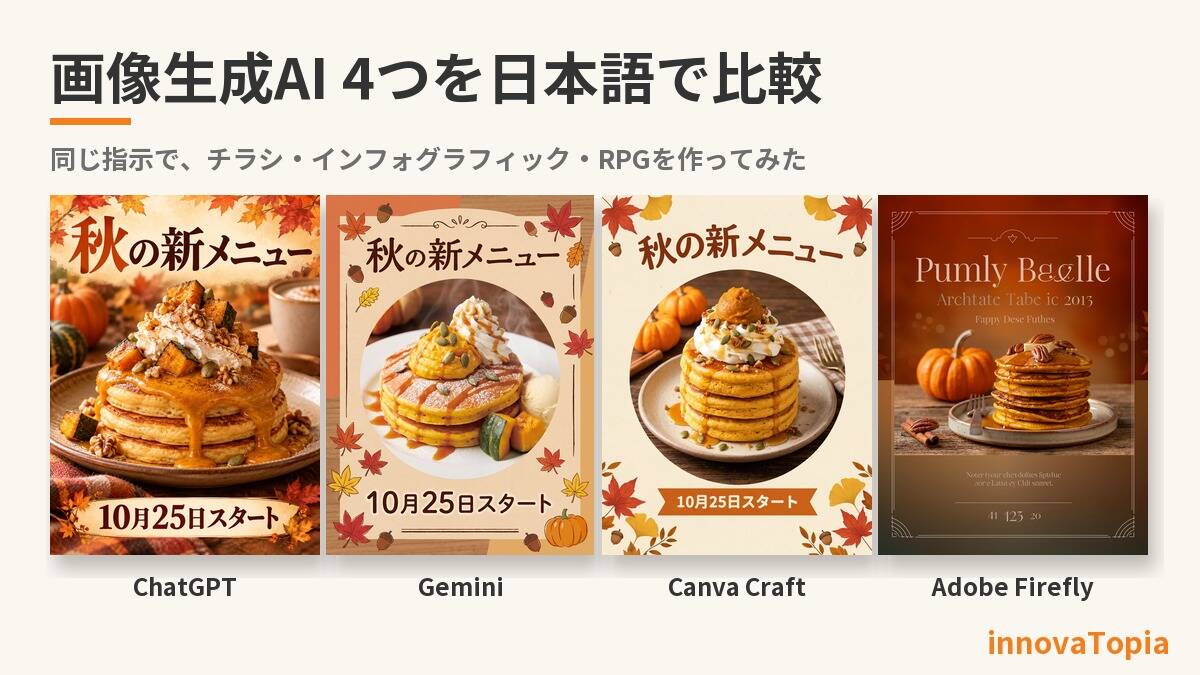
縦横比3:4のチラシ画像。カフェの秋の新メニューを知らせるチラシ。中央にかぼちゃのパンケーキの写真、上に大きく「秋の新メニュー」、下に「10月25日スタート」と入れる。指定した2つ以外の文字は入れない
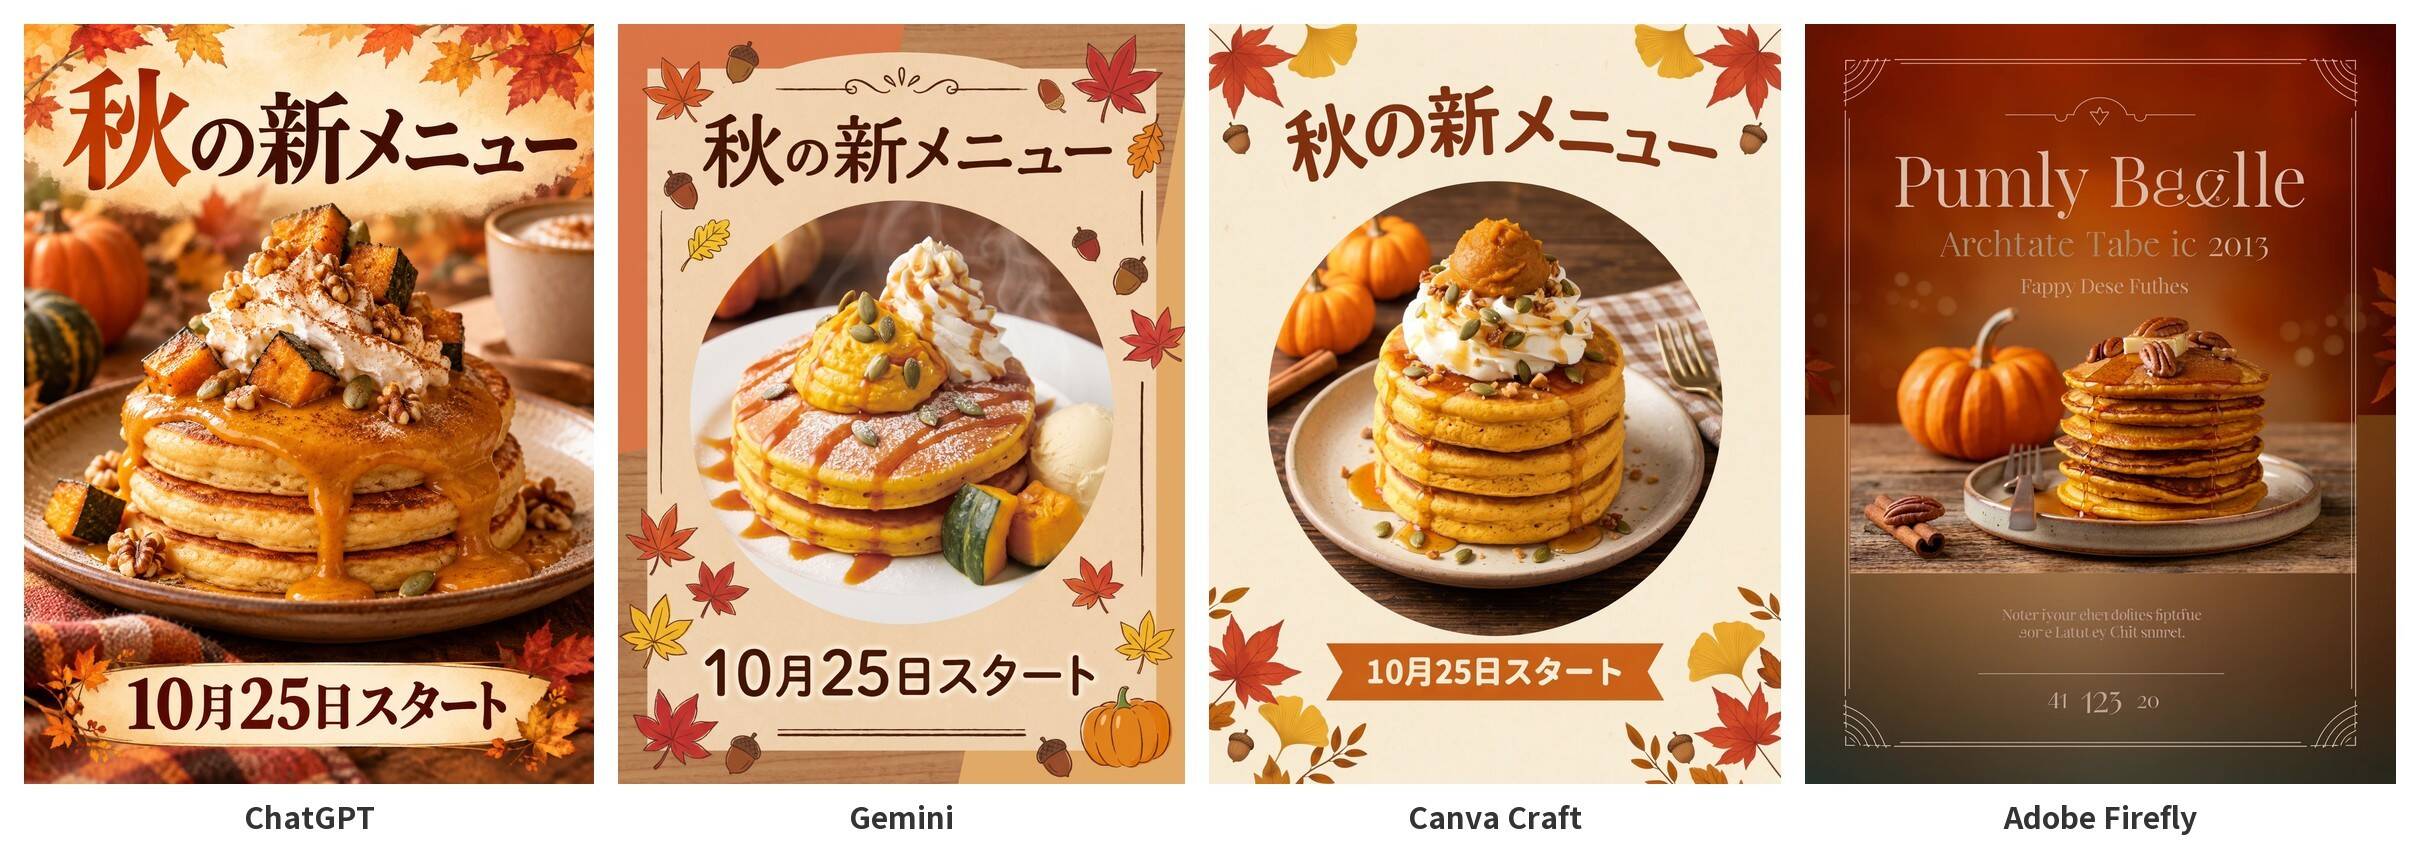
ChatGPT、Gemini、Canva Craftの3つは、指定した2つの日本語を正確に描きました。頼んでいない文字も、どれにも入っていません。Canva Craftは、4枚の案すべてで文字が正確でした。
違いが出たのは、仕上がりの方向性です。ChatGPTは写真を画面いっぱいに使う作り、Geminiは写真とイラストを組み合わせた手作り風、Canva Craftは丸く切り抜いた写真のまわりに飾りを添える構成でした。
Adobe Fireflyの自社モデル「Firefly Image 5」は、日本語を1文字も描きませんでした。代わりに「Pumly Beelle」のような、意味をなさない英字風の文字列と数字が入りました。写真の部分は自然に描かれています。
お題2:日本語160字でも、3つは1文字も間違えませんでした
2つ目のお題は、文字の多いインフォグラフィックです。タイトル、副題、5つの手順の見出しと説明文、ポイント欄まで、描く日本語は合わせて160字あります。番号付きの丸、アイコン、緑のアクセントカラーなど、構成の指定も細かく入れました。
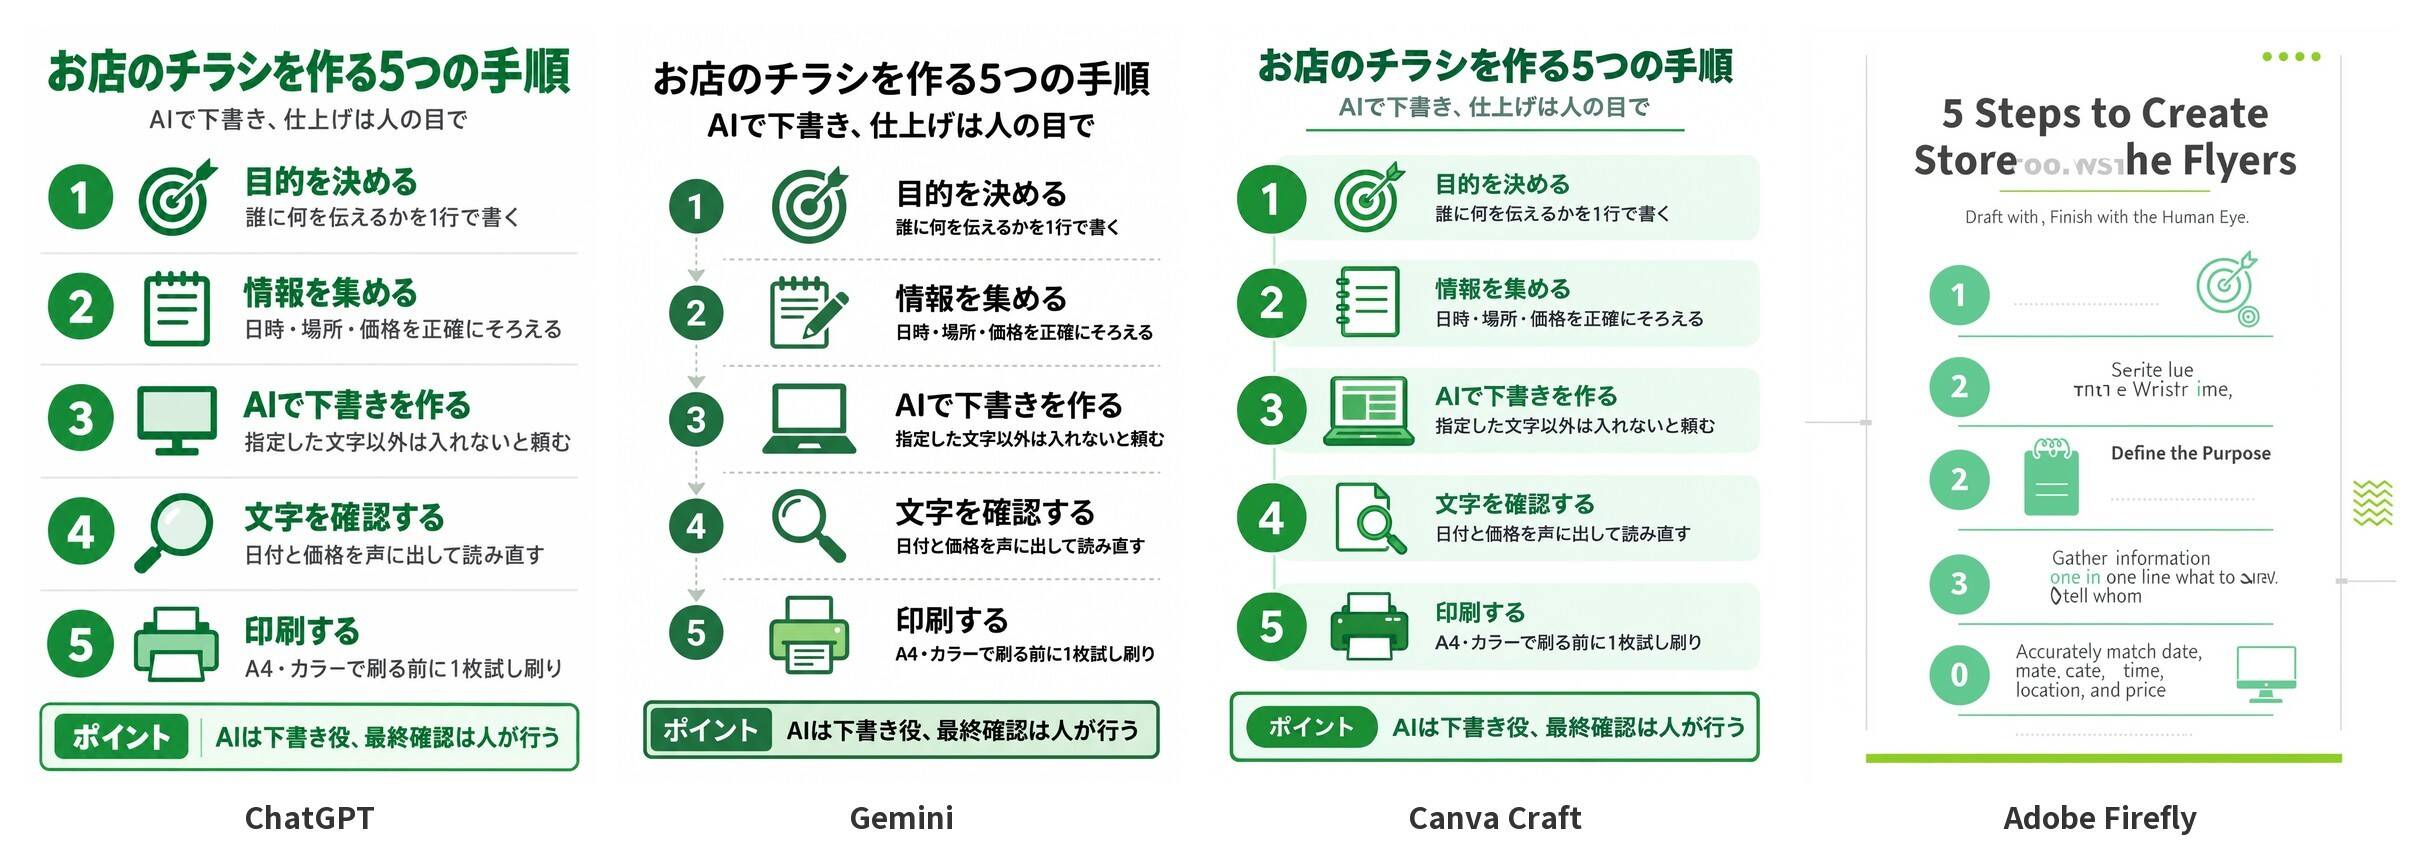
ChatGPT、Gemini、Canva Craftの3つは、160字をすべて正確に描きました。「誰」「確」「頼」「刷」のような画数の多い漢字も崩れていません。5つの手順の順番、指定した5つのアイコン、ポイント欄の配置も、3つとも指示どおりでした。
3つの違いは、見出しの色や行の区切り方、アイコンの描き方といった見た目の部分にとどまります。日本語のインフォグラフィックの下書きとして、どれも十分な水準でした。
Firefly Image 5は、ここでも日本語を描きませんでした。指示を英語に訳したような断片的な文字列が並び、番号は「1・2・2・3・0」と重なり、手順の一部とポイント欄が欠けています。
お題3:英語の長い指示では、結果が大きく分かれました
3つ目のお題は、都市名を入れると、その街をモチーフにしたドット絵のRPGの画面を描く指示文です。筆者が作成し、異業種交流会「クロストーク」のサイトで公開しているもので、英語を中心に、改行を含めて約3,800字あります。今回は都市を兵庫県姫路市にし、右下の署名だけを「innovaTopia」に変えました。主人公の参考として、innovaTopiaの解説動画に登場するAIキャラクター「伊野部トピ子」の画像を添付しています。
左上に「HIMEJI」、右下に「innovaTopia」の2つの文字だけを入れること、主人公の大きさ、冒険者の人数、名所の扱いなど、細かな条件が並ぶ指示です。筆者自身が作った指示文なので、特定のツールの書き方に合っている可能性がある点は、あらかじめお断りしておきます。
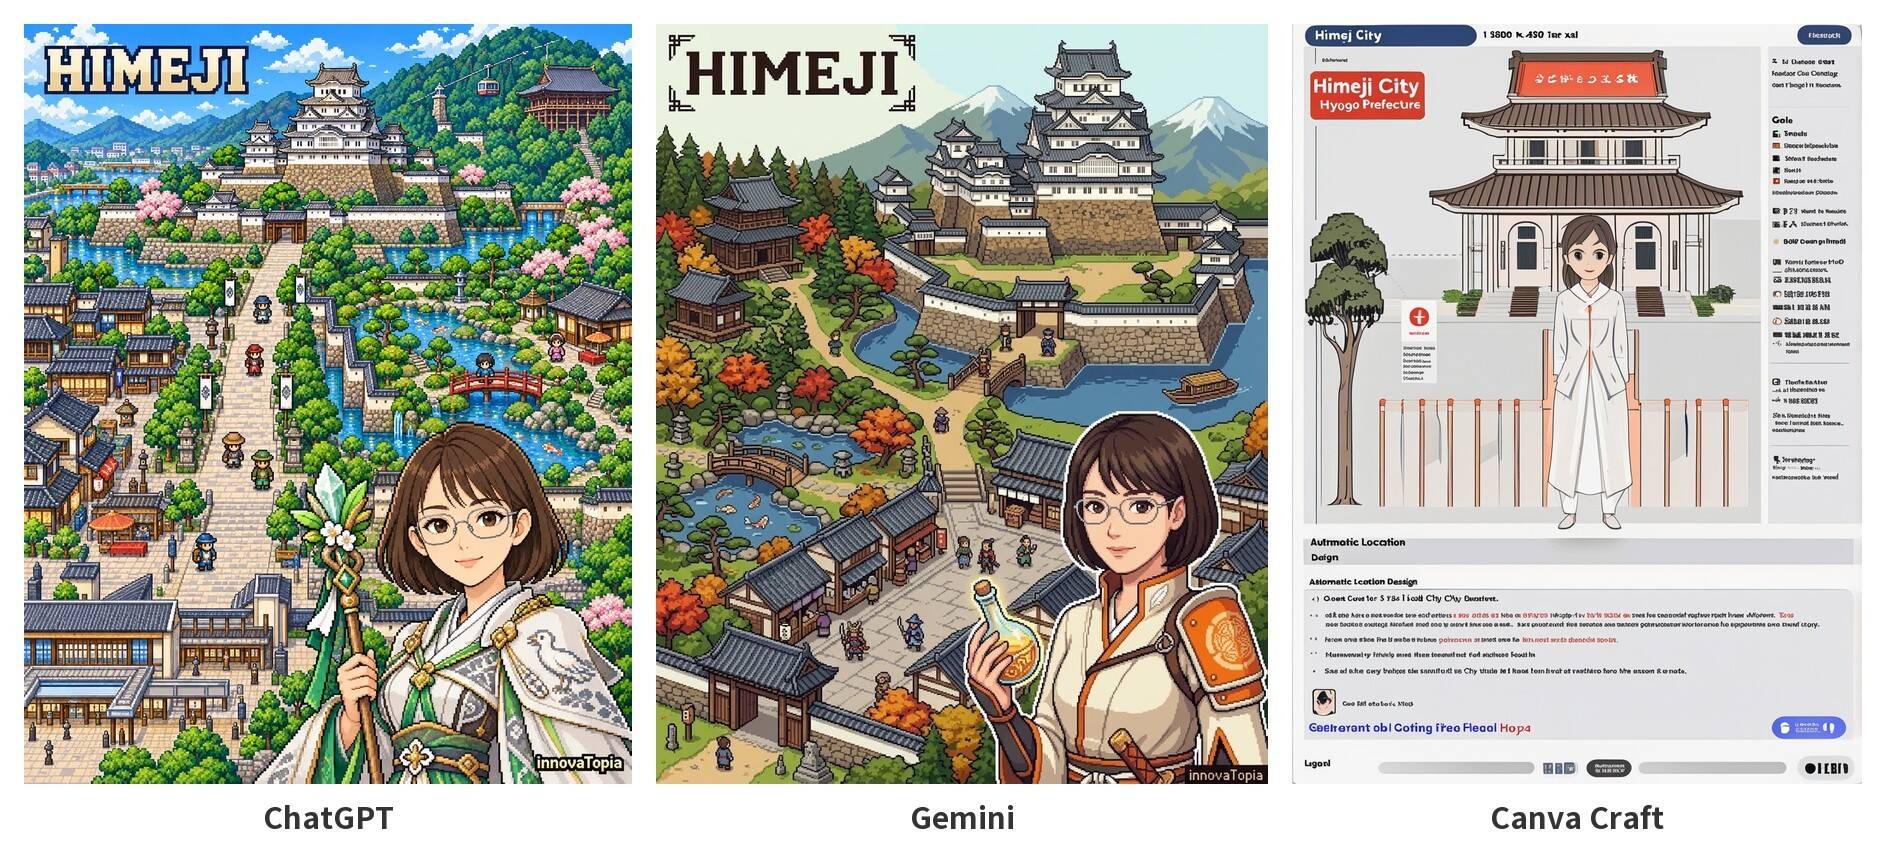
ChatGPTは、指示にかなり近い1枚を描きました。中央上に姫路城を置き、駅から城へまっすぐ延びる大通りという実際の位置関係まで表現しています。主人公はトピ子の髪型やメガネを保ち、マントには白鷺の刺繍が入りました。姫路城の別名「白鷺城」にちなんだ表現と考えられます。
Geminiも、姫路城と城下町、2つの文字を正しく描きました。主人公の配色にはトピ子のジャケットのオレンジを引き継ぎ、全体のドット絵の統一感も高い仕上がりです。一方で、城の背後には雪をかぶった高い山が描かれ、実際の姫路の景色とは合いません。
ChatGPTとGeminiに共通して、主人公は指示の大きさ(画面の横幅の30〜35%)より大きく描かれました。店ののれんや看板に、文字のような模様が入ったのも共通しています。
Canva Craftは、4枚ともドット絵になりませんでした。指示文の見出しにあたる「Automatic Location Design」のような文字列が画面に並び、仕様書やWebページのようなレイアウトになっています。「HIMEJI」と「innovaTopia」も入らず、建物も姫路城とは違うものでした。トピ子の画像を添付しても、顔立ちは再現されていません。
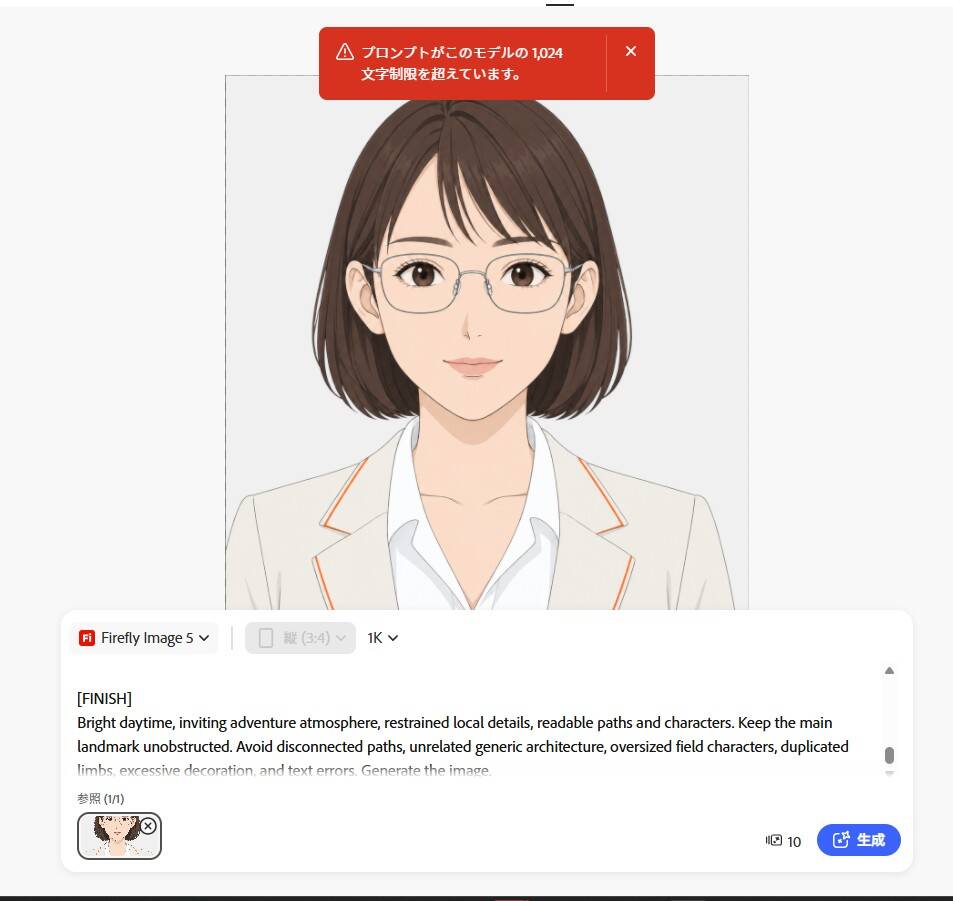
Adobe Fireflyは、そもそも生成できませんでした。今回使ったFireflyの画面では「このモデルの1,024文字制限を超えています」と表示されました。指示文は、表示された上限の約3.7倍の長さでした。
指示を短くすると、どう変わるか
Canva CraftとFireflyの結果が、指示の長さによるものなのかを確かめるため、要素を絞った約500字の英語の指示文でも試しました。比較の本番とは条件が違うため、参考として紹介します。
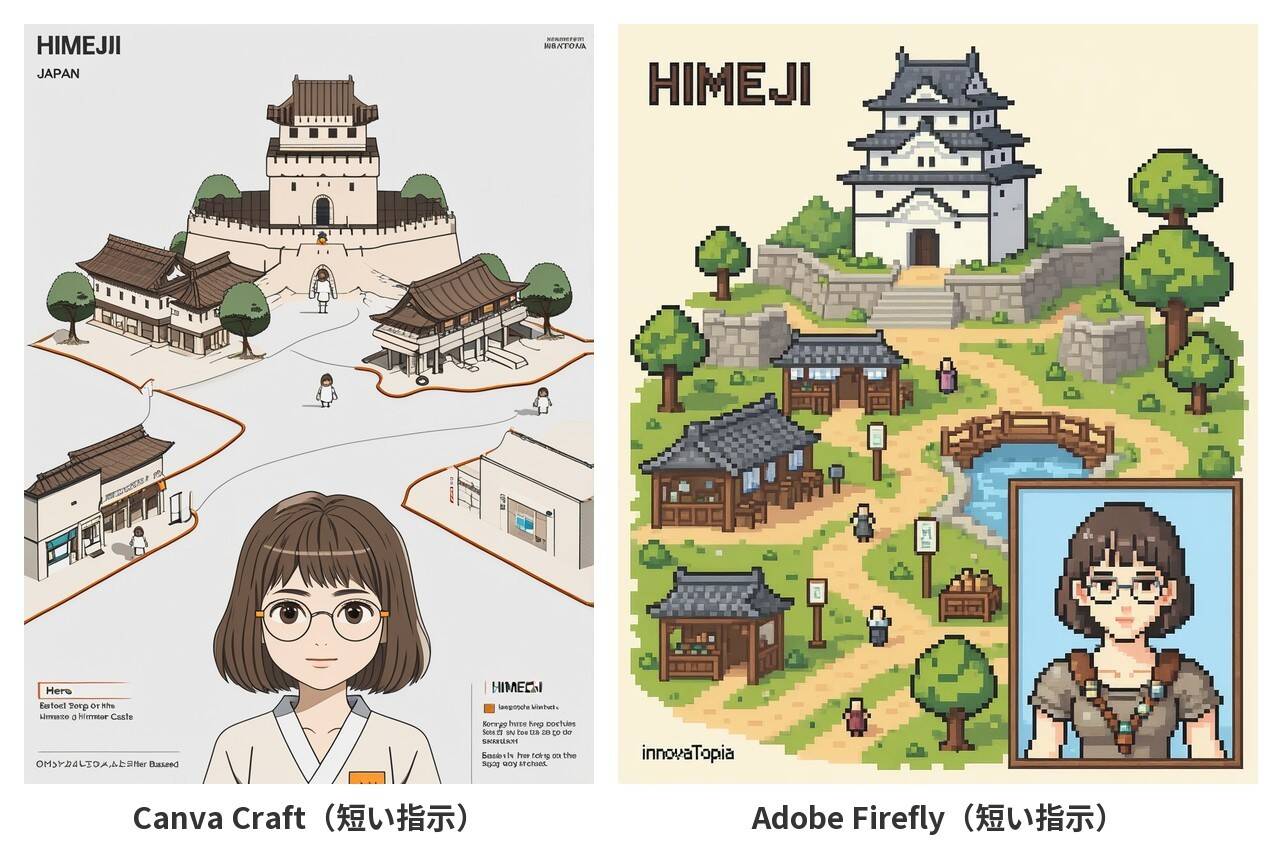
Fireflyは、短い英語の指示なら、ドット絵の街と「HIMEJI」「innovaTopia」の2つの文字を描きました。署名は右下ではなく左下に入り、城も単純化されていますが、文字そのものは正確です。日本語を指定した2つのお題では文字が描かれず、短い英語のお題では英字が描かれたことになります。ただ、題材も文字の量も違うため、日本語そのものが原因かは、今回の試行だけでは切り分けられません。
Canva Craftは、短くしてもドット絵になりませんでした。画風はフラットなイラストの地図に近づいたものの、タイトルは「HIIMEJI」「Himejj」など綴りが崩れ、署名も4枚とも正しく描けませんでした。「3:4」という文字が画面に描かれた案もあります。長い指示でも短い指示でもドット絵にならず、短い指示では英字の綴りにも問題が残りました。日本語のデザイン物で見せた正確さとは対照的な結果です。
生成のあと:マジックレイヤーでの分かれ方
前回の記事では、Canvaの「マジックレイヤー」で、生成した画像を文字や写真の部品に分け、文字を書き換えられることを確かめました。マジックレイヤーは、ChatGPTやGeminiで作った画像にも使えます。そこで、RPGの画像でも分かれ方を見比べました。
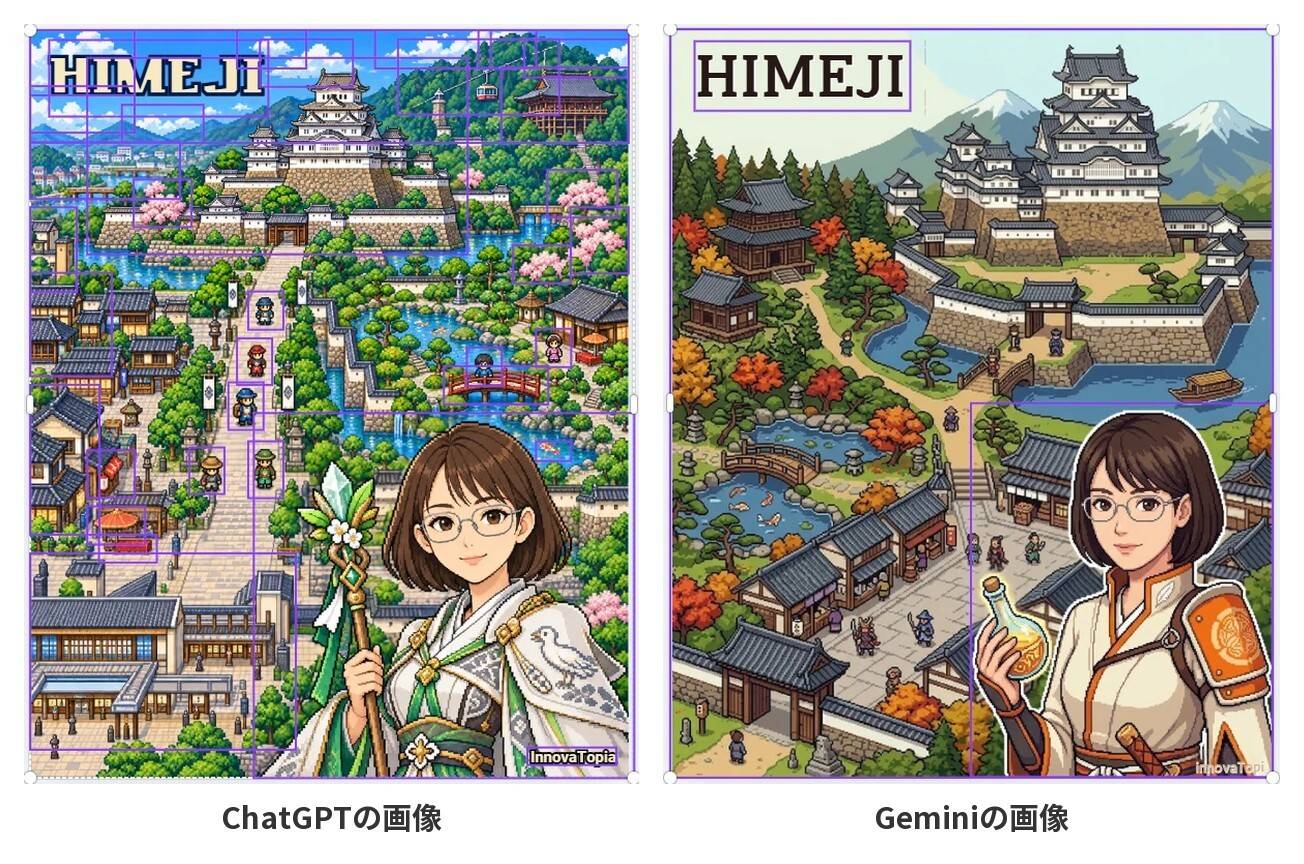
ChatGPTの画像は、城、寺、桜の木、冒険者1人ずつ、橋、店、主人公まで、細かな部品に分かれました。Geminiの画像は、画面で見る限り、タイトル、主人公、背景の3つの大きな部品に分かれただけでした。同じ機能でも、元の画像によって分かれ方は大きく変わります。
もうひとつ、気をつけたい点も見えました。変換したあとの文字が、元の画像と変わっていたのです。ChatGPTの画像では署名が「InnovaTopia」と先頭が大文字になり、Geminiの画像では「innovaTopi」と最後の1文字が欠けていました。Geminiの画像のタイトルも、ドットの輪郭が目立つ文字から、滑らかな太字に変わっています。
Canvaによると、マジックレイヤーは画像全体を認識し、文字や物体、背景を編集できるデザインとして組み立て直す機能です。変換すれば安心ではなく、変換したあとにもう一度文字を確かめる必要があります。
なお、Canvaは公式発表で、Craftの画像はマジックレイヤーで編集できるレイヤーに変換しやすいと説明しています。今回はCraftのRPGがドット絵にならなかったため、同じ条件での比較はできていません。
Fireflyの中には、他社のモデルも並んでいました
Fireflyで試す途中で、もうひとつ気づいたことがあります。モデルを選ぶメニューに、Adobeのモデルと並んで、「パートナーモデル(他社が作成したモデル)」としてGoogleのGemini 3.1(Nano Banana 2)や、OpenAIのGPT Image 2.5などが表示されていました。しかも、最初に選ばれていたのはGemini 3.1でした。
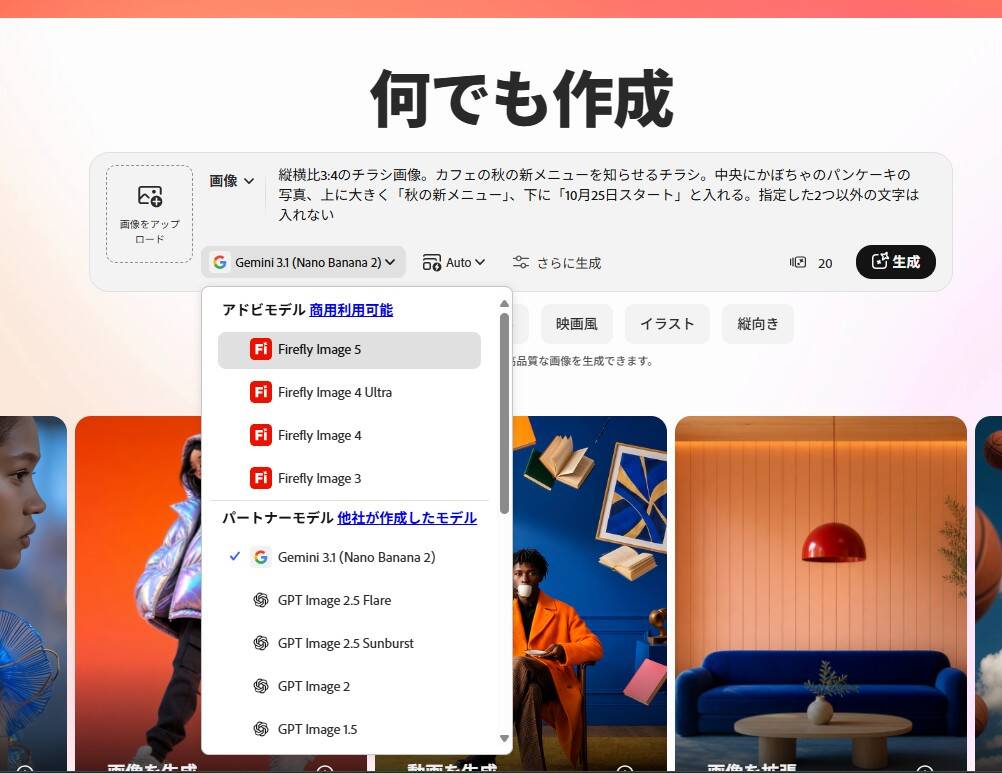
Adobeは自社のモデルにだけ「商用利用可能」と表示し、他社のモデルと区別しています。日本語の文字が欠かせないチラシをFireflyで作るなら、パートナーモデルを選ぶという使い方も考えられます。
何を作るかで、選ぶAIが変わる
今回の結果をまとめると、次のようになります。
| チラシ(日本語) | インフォグラフィック(日本語160字) | RPG(英語の長い指示) | 1回の枚数 | |
|---|---|---|---|---|
| ChatGPT | 正確 | すべて正確 | ドット絵の街、文字は正確(主人公が指定より大きく、顔は滑らか) | 1枚 |
| Gemini | 正確 | すべて正確 | ドット絵の街、文字は正確(主人公が大きい、人数が多い、実際にない雪山) | 1枚 |
| Canva Craft | 4枚とも正確 | すべて正確 | ドット絵にならず | 4枚 |
| Adobe Firefly | 日本語が入らない | 日本語が入らない | 入力の上限で生成できず(短い英語の指示では英字を描けた) | 1枚 |
日本語のチラシやインフォグラフィックのような「デザインの下書き」では、ChatGPT、Gemini、Canva Craftの3つが、どれも文字を正確に描きました。今回の2つのお題では、文字の正確さに差は出ませんでした。
その中でCanva Craftの持ち味は、1回の生成で構図の違う4案が出ること、そしてCanvaの編集画面にそのままつながることです。ChatGPTやGeminiにも、Canvaとの連携でマジックレイヤーに画像を渡す方法が用意されていますが、今回はその流れまでは比べていません。普段Canvaでチラシを仕上げている筆者にとっては、案出しから仕上げまでを1つの画面で続けられる手軽さが便利に感じられました。
一方、今回のRPGの指示では、ChatGPTとGeminiが街をドット絵で描いたのに対し、Canva Craftは仕様書のようなレイアウトになり、Fireflyは入力の上限で生成できませんでした。何がこの差を生んだのか、ほかの題材でも同じ傾向が出るのかは、今回の試行だけでは分かりません。
今回の結果は各お題1回の観察で、製品全体の得意・不得意を決めるものではありません。それでも、出力の傾向がAIごとにはっきり違うことは確かめられました。そしてどのAIを使っても、最後に文字を確かめる人の目は欠かせません。作りたいものに合わせてAIを選び分けること。それが、いまの画像生成AIとのいちばん賢い付き合い方なのかもしれません。
【関連記事】
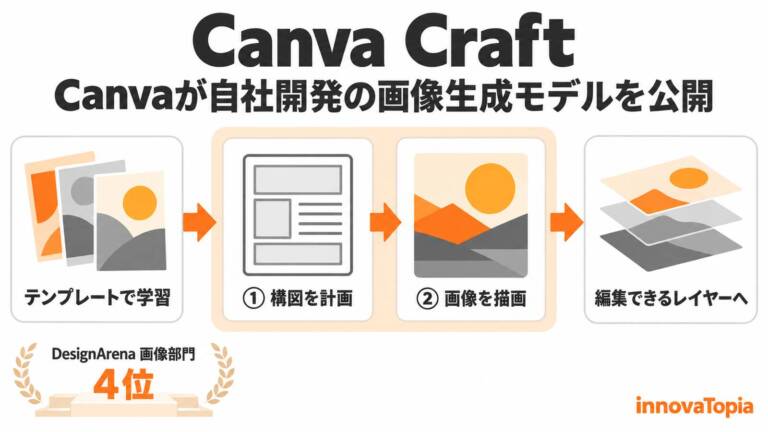
Canva、自社開発の画像生成モデル「Canva Craft」を公開 DesignArena画像部門で4位
Canva Craftの発表を伝えた記事。テンプレートを含む学習データ、2段階の生成方式、DesignArenaの順位の読み方を解説した。
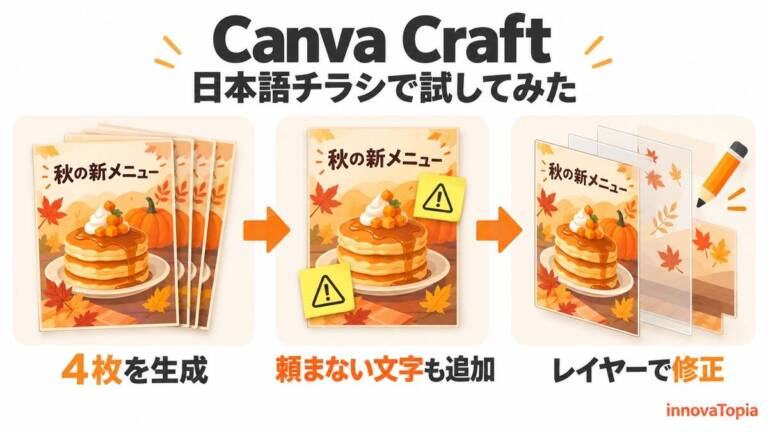
Canva Craftを日本語チラシで試した|文字は正確、頼まない提供時間も追加
Canva Craftを日本語のチラシで試したレビュー。頼まない文字の追加と、マジックレイヤーで書き換える方法を紹介した。
【編集部後記】
Adobe Fireflyのモデル選択の欄には、Adobe自身のモデルの下に、GoogleとOpenAIのモデルが並んでいました。しかも、最初に選ばれていたのは他社のモデルでした。
デザインツールを選ぶことと、画像を描くモデルを選ぶことは、もう同じではなくなりつつあります。CanvaもCraftを公開APIで提供し、MCPでの提供も予定しています。数年後には、使い慣れた画面の中で、その日のお題に合うモデルを選ぶのが当たり前になっているのかもしれません。
【用語解説】
マジックレイヤー(Magic Layers)
Canvaの機能。1枚の画像から文字や写真、飾りなどを読み取り、個別に動かしたり書き換えたりできる部品に分けて組み立て直す。
インフォグラフィック
情報や手順を、文字とアイコン、図などを組み合わせて、ひと目で分かるようにまとめた画像。
ドット絵(ピクセルアート)
小さな四角い点の集まりで描く絵。1990年代の家庭用ゲーム機の画面を思わせる表現として、今も根強い人気がある。
パートナーモデル
Adobe Fireflyの中で選べる、他社が作った画像生成モデル。GoogleのGeminiやOpenAIのGPT Imageなどが並ぶ。
【参考リンク】
ChatGPT(外部)
OpenAIの対話型AIサービス。会話の中で画像の生成や編集を頼める。今回はChatGPT Pro 100のプランで試した。
Gemini(外部)
Googleの対話型AIサービス。画像生成にはNano Bananaのモデルを使う。今回はGoogle AI Proのプランで試した。
Canva(キャンバ)(外部)
オーストラリア発のオンラインデザインツール。左のメニューのドリームラボから、自社開発の画像生成モデルCanva Craftを使える。
Adobe Firefly(外部)
Adobeの生成AIサービス。自社のFireflyモデルに加え、GoogleやOpenAIが作ったパートナーモデルも選べる。
あなたの街がRPGになったら?都市名だけで作れる画像生成プロンプトを公開!(外部)
筆者が作成し、異業種交流会クロストークのサイトで公開している、都市名を入れるだけでRPG風の画像を作れる画像生成AI向けの指示文。