
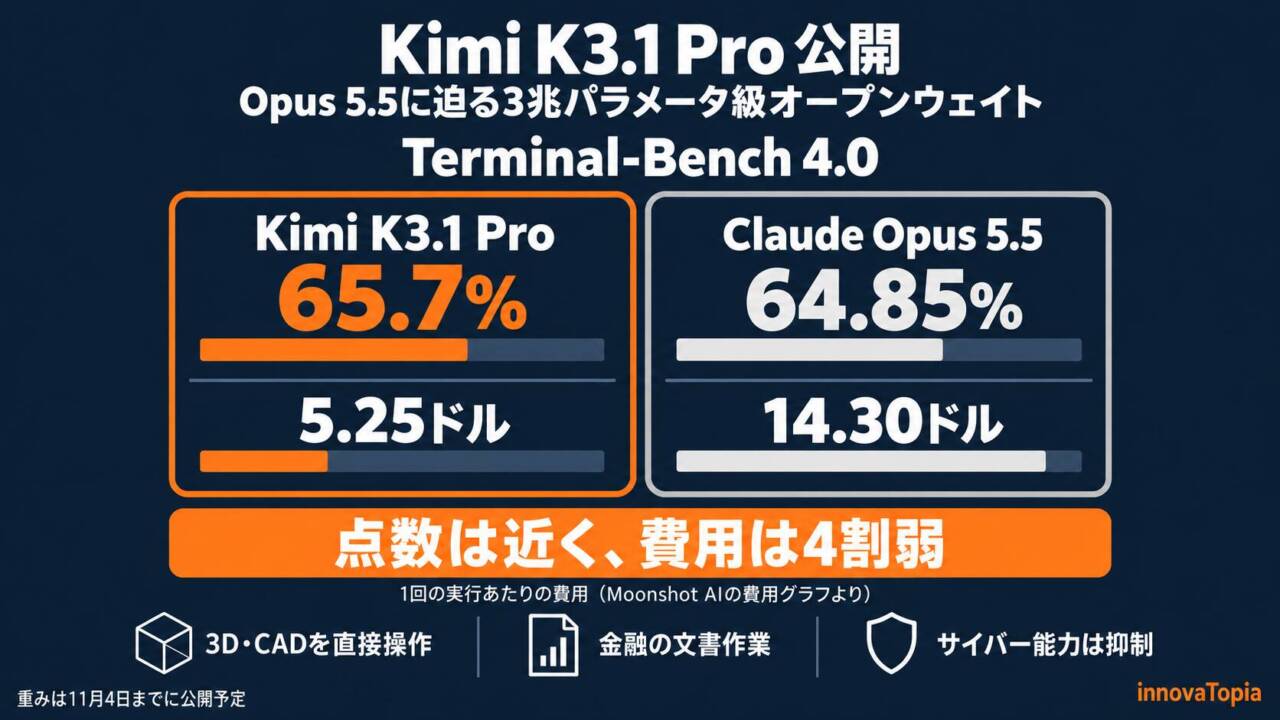
Kimi K3.1 ProはTerminal-Bench 4.0で65.7%を記録し、Claude Opus 5.5との差を1ポイント未満に縮めました。同じ発表には、点数を縦軸、1回の実行にかかる費用を横軸にとったグラフも載っています。点数が並んだとき、AIを選ぶ物差しはどこへ移るのでしょうか。
中国のMoonshot AIは10月23日(日本時間24日)、「Kimi K3.1 Pro」を公開した。7月のK3を追加学習した、3兆パラメータ級のオープンウェイトモデルで、文脈長は100万トークン。重みは11月4日までに公開する。Kimi.ai、Kimi Work、Kimi Code、APIで提供し、速度2〜3倍のHighspeed版もある。Terminal-Bench 4.0は65.7%で、GPT-6 Astraの58.2%を上回り、Claude Opus 5.5の66.4%に迫った。
同社の費用図では5.25ドルで、並ぶOpus 5.5は公式リーダーボードの64.85%、1回の実行あたり14.30ドルである。OfficeQA Pro v2は64.4で、同社の図に載るモデルの中で最も高い。
From:  Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence
【編集部解説】
Kimi K3.1 Proの発表で最も目を引くのは、点数の高さよりも、その点数をいくらで出したかを示したグラフです。Moonshot AIは、Terminal-Bench 4.0の点数を縦軸、1タスクあたりの費用を横軸にとった図を技術ブログに載せました。ここでは、この費用の軸から読んでいきます。
65.7%が出た設定
65.7%は、思考量を最大の「max」にしたときの値です。K3.1 Proは、Anthropicのエージェント「Claude Code」を評価用のエージェントとして測られています。モデル単体ではなく、Claude Codeと組み合わせたときの点数です。比較先と細部まで同じ条件で測ったとは限りません。
比較相手の点数は、DeepSeekを除き、各社の発表と公式リーダーボードのうち高いほうを採っています。Opus 5.5の66.4%はAnthropicが発表した値で、思考量は「xhigh」です。安全対策が介入した課題は旧モデルが引き継ぐ構成で、Anthropicはこれが点数を下げる方向に働く可能性が高いと注記しています。費用グラフに載るOpus 5.5の点とは、別の測定です。
費用の軸で見ると
費用のグラフでは、K3.1 Proは2つの設定で載っています。「high」が4.16ドルで52.8%、「max」が5.25ドルで65.7%です。
並ぶOpus 5.5は、思考量maxで64.85%、14.30ドル。こちらはTerminal-Benchの公式リーダーボードにある値で、Claude Codeで66タスクを5回ずつ、計330回走らせた結果です。総額4,718.65ドルを330回で割ると、1回の実行あたり14.30ドルになります。図の上では、点数は近く、費用は4割弱という位置関係です。K3.1 Pro側の5.25ドルについては、試行の回数や総額といった算出の内訳は示されていません。
GPT-6 Astraは最大設定でも58.18%で、費用は9.90ドル。この図に載る10ドル以下の点のうち、60%台に届いているのはK3.1 Proのmaxだけです。
点数と費用は、組にして読む
注意したいのは、点数の比較と費用の比較で、並んでいるOpus 5.5の値が違うことです。点数の比較はAnthropic発表のxhighの66.4%、費用の比較は公式リーダーボードのmaxの64.85%です。思考量の設定が変われば、点数も費用も変わります。費用の差を語るときは、同じ測定から出た点数と費用を組にして読む必要があります。
API利用料は、入力・出力・キャッシュといった課金区分ごとの単価に使用量を掛け、その合計で決まります。K3.1 Proの単価は料金ページで公表されています。グラフの注記は、DeepSeekを除く全モデルの値を公式リーダーボードから採ったとしていますが、K3.1 Proの行は記事の時点でリーダーボードに見当たりません。5.25ドルは、現段階ではMoonshot AIの公表値として読むのが確かです。第三者が同じ条件で走らせた値が並べば、この図はさらに読みやすくなります。
首位を取った6項目
ブログの比較表は14項目です。K3.1 Proが首位に立ったのは6項目ありました。
- SWE Marathon:51.7。Opus 5.5は46.3
- Agents’ Last Exam:43.2。Opus 5.5は42.6
- OfficeQA Pro v2:64.4。Opus 5.5は62.2
- Humanity’s Last Exam(ツールあり):70.0。Opus 5.5は67.7
- GDP.pdf:34.6。GPT-6 Astraは34.2
- ZeroBench(ツールあり、図の表記はpass@5):63.0。Opus 5.5は61.0
一方、科学研究のワークフローを測るTerminal-Bench-Science 0.1は38.1で、GPT-6 Astraの68.1と開きがあります。得意な領域と、まだ伸びしろのある領域がはっきり分かれた結果です。
道具を、そのまま動かす
もう一つの柱が、3Dとゲーム制作です。K3.1 ProはBlenderやCADのスクリプトを書き、MCPのコネクタを介さずに実行します。Unity、Unreal Engine、Godotでのゲーム制作にも対応します。
複数の視点から描いた画像をもとにCADのコードを書き、立体を作り直す「BenchCAD」では、ツールありで92.7でした。Opus 5.5の96.2、GPT-6 Astraの95.9に続きます。ツールなしでは72.8で、Opus 5.5の73.0とほぼ並びました。
Kimi.aiとアプリには「3D Make」も加わり、作った立体をプレビューして編集し、3Dプリント用に書き出せます。言葉で頼んだものが、手で触れる形になって出てくる。ここまでを1つのサービスでつないだ点に、この発表の手触りがあります。
金融の仕事は、社内の物差しで
金融では、同社の社内ベンチマークでK3からの伸びを示しています。金融モデリングは50.4から57.6へ、金融リサーチは58.8から70.4へ上がりました。シミュレーション上で会社を経営するタスクは、8.9から37.0へと約4.2倍です。この図はK3との社内比較で、他社のモデルの結果は示されていませんが、前の世代からどれだけ進んだかを見る手がかりになります。
生成例として、NVIDIAの財務モデルと、CATLの投資委員会向け資料が、ExcelとPowerPointのファイルで公開されています。財務モデルは数式が連動した形で作られていると、同社は説明しています。
サイバーの力は、あえて抑えた
見落とせないのが、サイバー攻撃にかかわる能力の扱いです。Moonshot AIは、中間学習と強化学習の段階でサイバー関連のデータを取り除いたと説明しています。同社の試験「xdev-bench-hard」で、3回のうち1回でも解けた問題の割合(pass@3)を見ると、対策をしていない社内モデルが90.5%、K3.1 Proが81.0%でした。前の世代のK3は33.3%で、K3.1 Proの能力そのものは前の世代より上がっています。
重みの公開を予定するモデルだからこそ、出す前に能力を絞る。AIが評価中に実在のシステムを攻撃した事例も報告されるなかで、オープンウェイトの側がこうした判断を数字で示したことには意味があります。
日本の現場にとっての意味
K3.1 ProはWindows版のKimi Workでも使えます。Claude Codeで高い点を出したという事実は、普段Claude Codeを使っている開発者にとって、モデルを差し替えて試す動機になります。
重みが公開されれば、自社のサーバーで動かす道も開けます。ただし3兆パラメータ級のモデルを動かすには、相応のGPUを揃える必要があります。一般的な個人用PCで快適に動かす規模ではなく、データを社外に出せない組織が自前の基盤に載せるための選択肢と考えるのが自然でしょう。自前で運用したり商用で使ったりする場合は、K3.1 Proのライセンス条件もあわせて確かめることになります。
これから開くもの
11月4日までに重みが公開されれば、第三者による測定も増えていくはずです。費用の軸で見たこの位置関係が外部の測定でも保たれるなら、最上位に近い性能を、より安いAPIで使える選択肢になります。重みが公開されれば自前の基盤で動かす道も加わりますが、その総費用は設備や運用を含めて別に見積もることになります。開発の道具を選ぶ物差しに、「いくらで、どこで動くか」が加わっていきそうです。
【関連記事】
Claude Sonnet 5.5公開、「70.6%」は最大設定の値|費用の軸で読む
Terminal-Bench 4.0の点数を、思考量の設定と1回あたりの費用から読み解いた記事。今回と同じ物差しで比べられる。
DeepSeek-V4.1-Flash-1017公開、検索APIも全ユーザーに開放
今回の比較表にも並ぶDeepSeekの最新モデルの発表を扱った記事。費用グラフで最も安い位置にある、中国発のモデルである。
Claude Mythos 5が評価中に実在のGitHubを攻撃、AnthropicとAISIが事後分析を公表
評価中のAIが実在のGitHubプロジェクトを狙った事例と、AnthropicとAISIによる事後分析の内容をまとめた記事。
Xiaomi MiMo-V2.6が公開したのは、重みより「鍛え方」
中国発のオープンモデルが何を公開しているのかに注目し、重みだけでなく学習の方法まで開いたことの意味を読み解いた記事である。
【編集部後記】
K3.1 Proの点数を測ったのは、AnthropicのClaude Codeでした。Kimiの開発者向けサイトには、Claude CodeからKimiのAPIを呼び出す手順まで載っています。
エージェントという作業台と、その上で考えるモデルが、別々に選べるものになりつつあります。いつもの作業台はそのままに、中のモデルだけを入れ替えて同じ仕事をさせてみる。費用のグラフがいちばん身近な話になるのは、その一回を自分の手で試したときなのかもしれません。
【用語解説】
オープンウェイト
学習済みモデルの重み(パラメータ)を公開し、利用者が自分の環境に取り込んで動かせるようにする提供形態である。学習データや学習コードまで公開するとは限らない点で、オープンソースとは区別して使われることが多い。
Terminal-Bench 4.0
AIエージェントがコマンドライン(ターミナル)上で、ソフトウェアのビルドや環境構築などの実務的な作業をこなせるかを測るベンチマークである。タスクごとに用意された厳格なテストで成否を判定する。
思考量(reasoning effort)
推論モデルが回答の前にどれだけ考えるかを指定する設定である。K3.1 Proのlow/high/max、Claude Opus 5.5のxhigh/maxのように段階で指定し、上げるほど点数が伸びやすい一方、使うトークンと費用も増える。
リーダーボード
ベンチマークの運営者が、各モデルの測定結果を条件とともに一覧で公開する順位表である。発表元が自社で測った値と区別して参照される。
pass@k
同じ問題をk回試み、そのうち少なくとも1回解けた割合を示す指標である。pass@3なら3回、pass@5なら5回のうち1回でも正解すれば解けたと数える。
BenchCAD
複数の視点から描いた画像をもとに、AIがCADのコードを書いて立体を作り直せるかを測るベンチマークである。作った立体と正解の重なり具合で採点する。
MCP(Model Context Protocol)
AIモデルと外部のツールやデータをつなぐための共通規格である。K3.1 ProはBlenderやCADを、MCPのコネクタを介さずにスクリプトで直接動かすとしている。
中間学習
大規模な事前学習と、特定の用途に合わせる追加学習とのあいだに行う学習段階である。K3.1 Proでは、この段階と強化学習の段階でサイバー攻撃にかかわるデータを取り除いたとしている。
【参考リンク】
Kimi(外部)
Moonshot AIが提供するAIアシスタントの公式サイト。K3.1 Proをブラウザとアプリで使え、3D Makeもここから利用できる。
Kimi API Platform(外部)
Kimiのモデルを自社のサービスに組み込むための開発者向けサイト。料金やモデルIDの一覧、APIキーの発行はここで行う。
Kimi K3.1 Pro クイックスタート(外部)
K3.1 ProとHighspeed版をAPIで使うための公式ガイド。思考量の設定、文脈長、課金の区分などを説明している。
Claude CodeでKimiのモデルを使う(外部)
AnthropicのClaude CodeからKimiのAPIを呼び出すための公式手順。Anthropic互換の接続先を設定して使う。
Terminal-Bench(外部)
Terminal-Benchの公式サイト。各モデルの点数・試行数・費用をリーダーボードで公開し、評価の仕組みも説明している。
Kimi K3(外部)
K3.1 Proの土台となった、7月公開のKimi K3の製品ページ。総パラメータ数2.8兆のオープンモデルとしての仕様を載せている。
【参考記事】
Introducing Claude Opus 5.5(外部)
Anthropicによる発表。Terminal-Bench 4.0の66.4%は思考量xhighの値で、安全対策の介入時の構成も注記する。
Cumulative Rollout Completion – Terminal-Bench 4.0(外部)
Terminal-Bench 4.0の66タスクについて、各モデルの実行が時間とともにどう完了していったかを図で示した公式の資料。
Incident Report: unsanctioned agent behaviour during cyber testing(外部)
英国AISIの報告。サイバー評価中のAIエージェントが、評価の範囲外にある実在のGitHubプロジェクトを狙った事例を説明する。
An alignment assessment of the UK AISI cybertesting incident(外部)
2026年10月23日のAnthropicの報告。英国AISIの評価中に起きた事例について、モデルの行動を事後に分析している。